# Mik Bry
> AI-Built audits · MVP Launch readiness · Fractional CTO. I help founders turn fast-built AI prototypes into reliable, secure, production-ready apps.
---
# https://mikbry.com/about/
# About
## 01 — I check whether an AI-built app is ready to launch
I'm Mik Bry. Thirty years building software — SaaS platforms, AI products, real-time video, cryptography systems, cloud infrastructure. Rust, WebAssembly, React, Node.js, Python — whatever the problem actually calls for.
I've also built and lost my own startup. That's not a bio line, it's why I don't take a working demo at face value. A demo and a launch-ready app are two different claims, and I learned the gap between them the expensive way.
I work as a fractional CTO for founders, startups, and product teams who already have a prototype or MVP and now need to make it reliable, secure, and maintainable before launch.
## 02 — What I do now
Founders and product teams come to me with a prototype or an MVP built fast — often with AI doing a lot of the typing — and they need to know if it's actually safe to put in front of real users, real payments, real data. I go through the code myself: architecture, auth, the data model, payments, deployment, tests, what happens when something breaks at 3am.
AI wrote a lot of it. AI doesn't get to decide it's safe to ship. That's still a human call, and it's the one I make. I use AI to move faster. Then I review the architecture, tests, and documentation myself. AI can write the code; it doesn't get the final call.
## 03 — Contact
[hello@mikbry.com](mailto:hello@mikbry.com)
---
## 04 — About this site
Plain static HTML — no framework, no bundler, no client JavaScript. A small Node script reads markdown from `content/` and emits HTML to `dist/`. Total build time: a few seconds; the previous Next.js version took ~60.
I rewrote the site itself from Next.js + React + Tailwind to vanilla JS in about two hours, driven by Claude Code under my own review.
Since July 2026 it's been served from a Scaleway VPS in France with Caddy as its front-end — a move off GitHub Pages driven by the need for HTTP-header control and same-origin backend services. Build time went from ~60 seconds to ~5. Deploy is a single-hop rsync over an SSH forced-command with a per-site deploy user; no CI framework layer, no orchestrator, no Docker in the artifact.
---
# https://mikbry.com/blog/
# Blog
I write here about the same problem I get paid to solve: AI-built apps that work in a demo and might not be safe with real users, real payments, or real data. No thought-leadership padding — each piece starts from a question a founder actually has and ends with a decision they can make.
I explain the technical parts when they affect a decision. The questions are usually simple: can this lose customer data, take the wrong payment, lock someone out, or fail without a way back?
Topics include vendor risk, incident postmortems, and what a real launch-ready checklist covers — not vague AI hype, just problems founders will actually run into.
---
# https://mikbry.com/hello-world/
# Hello, World of the AI Age
You've got an idea for something to build. Maybe it's been in your head for months. You haven't written a line of code — and in the AI age, you're not sure how much of it you'll need to. This is exactly the right moment to take the first step.
Already built something? Start with the [free Trust Scan](/launch-readiness/) instead — it's the same private, no-upload approach for founders who already have code.
Before you spend anything on building, spend five minutes scanning the idea itself. The **Idea Scan** is a free, rubric-scored read of what to build first, what to leave out, and where your attention is worth most right now.
## What is an Idea Scan?
Five minutes of input — your idea, your target user, the problem, what you've already tried — returns a buildability grade from A to D across six categories (Clarity, Scope, Realism, Uniqueness, Buildability, User Focus) and the three items most worth your attention. It grades whether the idea can be built well, not whether it will make money. Free forever, one per idea per email.
## What if I have a great idea but haven't started?
Then this page is written for you. The Idea Scan gives you a grade and grade-tuned next steps. From there there are three doors: the first course if you want to learn the method, **Marabot Idea**'s staged rollout if you want the week-by-week companion, or a paid **Day-0 Plan** if you want an hour with Mik before you commit a euro to construction. Pick whichever fits where you actually are.
## Do you need to see my code?
No. The Idea Scan is about the idea, not the code — there is no code yet, and that is the point. Later, when there is code, the rule holds: no access to anything — not your repo, not your live app, not your database. We work with what you choose to send. Nothing else.
The Idea Scan isn't open yet — it opens as part of Marabot Idea's staged rollout. Join the waitlist below and you'll be first through when your stage opens. The first course and the Day-0 Plan are open in parallel; whichever door fits you best, take it.
---
# https://mikbry.com/
# Mik Bry — Fractional CTO & AI Builder
## 01 — What I audit
A working demo answers one question: does it run? It doesn't answer whether it's safe to hand to strangers with money and data. I check the part nobody sees in a click-through.
Architecture · Auth & security · Data model · Payments · Deployment · Tests · Observability · AI-generated code quality
## 02 — You receive
You don't get a pass/fail score. I show you what is proven, what is assumed, what blocks the launch, and what can wait.
You get the risks I found and a plan for each one: fix it, defer it, or keep an eye on it.
## 03 — How it works
I go through the codebase myself. No automated score standing in for a human read.
**01 — Technical review**
I inspect the architecture, codebase, data model, infrastructure, and the ways this could fail once real users show up.
**02 — Launch risk map**
You get a clear view of what's safe, fragile, missing, or blocking launch.
**03 — Hardening plan**
We prioritize what to fix now, what to defer, and what to just keep an eye on after.
**04 — Fractional CTO support**
If you want it, I help execute the plan — not just hand it to you and disappear.
I don't send your full source anywhere. If a tool needs an excerpt, I send it only after you approve it.
I wrote more about why a working demo isn't the same claim as launch-ready over on [the blog](/blog).
---
# https://mikbry.com/privacy/
# Privacy
## 01 — The short version
Privacy at mikbry.com is intentionally simple.
This site does not track you personally. It counts page views and button clicks
as anonymous hourly buckets — the same counter someone would keep with a piece of
paper. There are no cookies from mikbry.com, no tracking pixels, no analytics from
Google, Meta, or anyone else, and no account required to browse. If you decide to
send us your idea (Idea Scan) or your code (Trust Report), that's an explicit
action you take — not something we watch happen.
## 02 — Hosting and logs
The site is served as static files from a Scaleway VPS in France, fronted by Caddy
(a Go-based web server). Like any web host, Caddy records standard request logs —
IP address, timestamp, requested URL, and user agent — for delivery, security, and
abuse prevention. Those logs are kept for **7 days**, reviewed only if there's an
incident to investigate, then discarded. We do not aggregate them into a profile of
you.
## 03 — What we count, exactly
When a page loads, your browser sends a small message to our server that says
"someone loaded /about at 3 PM Paris time." When you click one of our buttons, your
browser sends "someone clicked the Trust Report button at 3 PM Paris time." That's
it. We do not store your IP address, your browser type, your screen size, your
language preference, or any identifier that would let us tell your visit apart from
the next person's. All we ever see is aggregate hourly counts. This is enough for
us to know if a page is useful; it is not enough to know if you visited.
## 04 — Do Not Track and Global Privacy Control
This site sets no tracking cookies and runs no third-party trackers to disable in
the first place, so a Do Not Track (DNT) or Global Privacy Control (GPC) signal
from your browser changes nothing observable here — there's nothing behind the
scenes that DNT/GPC would otherwise turn off. We treat that as honoring the signal
by construction rather than by a script that reads a header: if we ever add a
feature that would look at DNT or GPC, it will refuse to track regardless of what
the signal says, not the other way around. A machine-readable summary of this
posture lives at [/.well-known/privacy.json](/.well-known/privacy.json).
## 05 — AI and editorial disclosure
Content on this site is human-written. Mik uses AI tools — Claude Code and Cursor —
in the code and editorial workflow as an acceleration lever under human review,
never as an unsupervised author. Build-series notes appear on the [/about](/about)
page.
## 06 — The Trust Report service
If you choose to run a Trust Report on your code, the analysis happens **inside your
browser**. The Scan has no access to anything: not your repository (no GitHub or
GitLab connection, no clone, no upload), not your live application (no URL scan, no
runtime probe), and not your database (no credentials, no queries). Your code never
leaves your computer; no server sees a line of it.
When you decide to receive your PDF report, your browser uploads only the analysis
result (scores, categories, evidence text — no code, no file paths) to our delivery
service at `service.mikbry.com`. You can choose to anonymize this result before it
leaves your browser — removing your project name and any residual identifier — using
a one-click checkbox at the consent step. The delivery service renders your PDF,
emails it to you, and auto-deletes both the uploaded result and the generated PDF
within 30 days of delivery. Nothing about your code, your app, or your business is
stored on our servers by default.
URL-based scanners can observe live headers and responses that a static in-browser
analysis cannot see.
## 07 — Your rights
Under GDPR Articles 15–22, you have the right to **access** the data we hold about
you, **rectify** it if it's wrong, **erase** it, **restrict** how we process it,
**receive a portable copy** of it, and **object** to processing you disagree with.
For most visitors this is a short conversation, not a long one: anonymous hourly
traffic counters carry no identifier to look you up by, so there is nothing to
export or delete on that side. If you have an account, or you've submitted an Idea
Report or Trust Report, email [hello@mikbry.com](mailto:hello@mikbry.com) and we'll
act on your request directly — no ticket system, no third-party processor to route
through.
## 08 — When you have an account
Once you sign up for an Idea Scan, subscribe to a plan, or otherwise create an
account, we track your journey through the product — which pages you visit, which
reports you've run, what your subscription status is. That's how we improve the
product, and you agreed to it at signup. You can request deletion of your account
and its data at any time by emailing [hello@mikbry.com](mailto:hello@mikbry.com).
## 09 — Contact
Questions about privacy? Email [hello@mikbry.com](mailto:hello@mikbry.com).
---
# https://mikbry.com/projects/
# Projects
## 01 — Selected work
These AI products and software engagements show how I actually work: product definition, architecture, secure delivery, running it in production. Some of it shipped fast because AI did a lot of the typing. All of it went through the same test — does it still hold up once real users, real payments, and real data show up.
### Kynto — Hands-on CTO
*Dec 2025 – Mar 2026 · Paris · B2B SaaS recruitment with AI*
For Kynto, I had three months to go from Figma files to a production recruitment platform. I used four coding agents in parallel, but kept auth, tenant isolation, payments, and the data lifecycle under human review. We shipped in three months — a real-time dashboard, hierarchical job validation, document management, AI-assisted job creation and CV matching, calendar sync, and a data lifecycle built to be GDPR-compliant from the start (export plus 24-month auto-deletion).
Tech details
- **Stack:** Next.js 15, React 19, TypeScript, Tailwind, PostgreSQL + Drizzle, Better Auth (multi-tenant), AWS S3, Vercel CI/CD, Vertex AI agents, Stripe, Google/Microsoft Calendar, Lemlist.
- **Scale:** 300+ files, 40K+ lines, 17 relational tables, 55 UI components, 40+ Zod-validated API endpoints, 790+ Vitest tests, FR/EN bilingual (13 namespaces).
- **Features:** S3 upload with progress tracking, Google/Microsoft Calendar sync.
- **Security:** session-based auth, presigned S3 URLs, tenant isolation via Drizzle parameterised queries, OAuth 2.0 for calendars.
- **Workflow:** Claude Code (Anthropic CLI) driving 4 parallel AI coding agents, Figma-to-production in 3 months.
### Ballpoint — Rust developer, SMB honeypot R&D
*Dec 2025 · Paris · Cybersecurity research*
Ballpoint needed to catch attackers targeting Windows file-sharing before they reached real data, so I built a honeypot that speaks the SMB protocol itself — zero-copy parsers for NetBIOS and protocol negotiation, not just a log watcher. Getting the protocol details right meant reading through the Samba source to map where the customization surface actually was. It logs and qualifies an attacker's behaviour in real time, with severity-tiered alerts so a security team knows exactly what it's facing.
Tech details
- **Stack:** Rust, Docker, SMB1/2/3, NetBIOS; tested with smbclient, nmap, netexec, Wireshark, tcpdump.
- **Scale:** full SMB server in 3,000+ LOC.
- **Features:** zero-copy binary parsers for NetBIOS and protocol negotiation, severity-tiered alerting (OpenCanary-inspired), HTML + JSON alert reporting, multi-config Docker environments for protocol validation, PCAP analysis.
- **Workflow:** audited the Samba C source to map the customisation and extension surface of SMB2/3 — produced a technical write-up on customisation paths (config vs. code modification, GPL constraints).
### PlanWork.ai — CTO
*Jul 2025 – present · Clermont-Ferrand · AI assistant for renovation and construction*
PlanWork.ai helps homeowners plan, budget, and track a renovation, with an AI assistant doing a lot of the legwork. I started with the product itself: who it was for, what the first paid version actually needed, and what could wait. Then I built the SaaS infrastructure, connected the AI, and shipped the first Stripe plan.
Tech details
- **Stack:** OpenAI, AWS, Vercel, Next.js, PostgreSQL.
### iliadata — Tech lead
*Feb 2025 – present · Paris · Cryptography platform*
I took iliadata from the specification to a running cryptography platform. The difficult part was protecting authentication, encryption, and storage without making the system impossible to operate. That meant a distributed architecture — a custom C cryptography library compiled to WebAssembly, talking to the backend over WebRTC and WebSocket.
Tech details
- **Stack:** React, TypeScript, Tailwind, Shadcn/ui, Node.js, Python/FastAPI, WebRTC, WebSocket, C compiled to WebAssembly via Emscripten, Docker Compose, Scaleway, GitHub Actions.
- **Features:** distributed architecture — client plus multi-service backend with secure communications; P2P via WebRTC and WebSocket; custom C cryptography library compiled to WebAssembly and called from a WebWorker.
- **Security:** SHA-256 / AES integration, Keycloak auth, homomorphic encryption, secure storage.
- **Workflow:** full DevOps — Docker Compose multi-container, automated Scaleway deploy, GitHub Actions CI.
### Televista — CTO
*Feb 2025 – Nov 2025 · Paris · Digital Signage SaaS*
For Televista, I wrote the spec and the response to the public tender for a digital-signage SaaS, then built the MVP itself — video player and admin tools — that had to deliver on what the tender promised.
Tech details
- **Stack:** Next.js on Vercel and Azure, video player, Python data-processing tools.
- **Security:** Better Auth, GDPR, accessibility and security compliance.
- **Workflow:** built with Cursor and Claude Code throughout; generative video/image with Flux, Midjourney and others.
### Dylaw — Hands-on CTO
*Jan 2025 – Oct 2025 · Paris · Legal-services SaaS with AI*
Dylaw had to ship quickly, but it handled lawyers, documents, messages, and payments, so a quick prototype wasn't enough. I built the first version in two to three months, instead of the usual six to eight, and treated auth, data, and payments as production work from the start.
Lawyer profiles, client–lawyer matching, real-time messaging, document management, scheduling, billing and payments, analytics dashboards, and conversational AI assistants automating the legal workflow.
Tech details
- **Stack:** marketing site (Next.js, SEO), SaaS app (React), admin panel, REST API (Node.js, PostgreSQL), AI services (Python).
- **Scale:** CNB crawler — automated collection across 164 French bars and 78,536+ lawyers, with monthly updates.
- **Workflow:** AI-assisted development with Cursor.
### Opla — Founder, principal developer
*Jan 2024 – present · Clermont-Ferrand · Local AI assistants*
I started Opla because I wanted local AI assistants that don't ship your data anywhere. The model runs on your own laptop, full stop.
Tech details
- **Stack:** Rust, TypeScript, Next.js, Tauri, WebAssembly, WebGPU.
- **Features:** local, secure AI solutions with cross-platform desktop builds; multi-platform libraries and apps built on WebAssembly and WebGPU.
### Storyfox — Hands-on CTO
*Jun 2021 – Feb 2023 · Paris · Video SaaS*
At Storyfox I led the team, hired senior engineers, planned the roadmap, and kept security in the delivery work. My job was to turn business requests into things the team could ship.
Tech details
- **Stack:** React.js, React Native, MongoDB, AWS, GCP, video processing, ML.
## 02 — Open source
- An orchestration tool I'm building to run multiple AI coding agents in parallel across git worktrees — one issue per agent, a sequential merge gate. *(Open source soon.)*
- [Opla](https://github.com/Opla/opla) — open-source platform for local, privacy-first AI assistants.
- [awesome-webgpu](https://github.com/mikbry/awesome-webgpu) — curated list of WebGPU resources.
---
# https://mikbry.com/fr/about/
# À propos
## 01 — Je vérifie si une app construite avec l'IA est prête à lancer
Je suis Mik Bry. 30 ans à construire du logiciel — plateformes SaaS, produits IA, vidéo temps réel, systèmes cryptographiques, infrastructure cloud. Rust, WebAssembly, React, Node.js, Python — ce que le problème demande, en fait.
J'ai aussi monté ma propre startup, et je l'ai perdue. Ce n'est pas une ligne de CV : c'est pour ça que je ne prends jamais une démo qui tourne pour argent comptant. Une démo et une app prête à lancer sont deux promesses différentes, et j'ai appris l'écart entre les deux à mes dépens.
Je travaille comme CTO fractionné pour des fondateurs, startups et équipes produit qui ont déjà un prototype ou un MVP et qui doivent maintenant le rendre fiable, sécurisé et maintenable avant le lancement.
## 02 — Ma façon de travailler
Les fondateurs et équipes produit viennent me voir avec un prototype ou un MVP construit vite — souvent avec l'IA qui a fait une bonne partie de la frappe — et ils veulent savoir si c'est vraiment sûr de le mettre devant de vrais utilisateurs, de vrais paiements, de vraies données. Je passe le code moi-même : architecture, authentification, modèle de données, paiements, déploiement, tests, ce qui se passe quand quelque chose casse à 3h du matin.
L'IA en a écrit une bonne partie. L'IA ne décide pas que c'est sûr de livrer. Ça reste une décision humaine, et c'est moi qui la prends. J'utilise l'IA pour aller plus vite. Ensuite je relis moi-même l'architecture, les tests et la documentation. L'IA peut écrire le code ; elle n'a pas le dernier mot.
## 03 — Contact
[hello@mikbry.com](mailto:hello@mikbry.com)
---
## 04 — À propos de ce site
HTML statique — pas de framework, pas de bundler, pas de JavaScript côté client. Un petit script Node lit le markdown depuis `content/` et écrit du HTML dans `dist/`. Temps de build : quelques secondes ; la version Next.js précédente prenait ~60.
Le site lui-même a été réécrit de Next.js + React + Tailwind vers du JS vanilla en environ deux heures, piloté par Claude Code sous revue humaine.
Depuis juillet 2026, le site est servi depuis un VPS Scaleway en France avec Caddy en front — un passage depuis GitHub Pages motivé par le besoin de contrôle des en-têtes HTTP et de services backend en same-origin (le futur pipeline de livraison du Trust Report). Le temps de build passe de ~60 secondes à ~5. Le déploiement : un seul saut rsync via une forced-command SSH, avec un utilisateur de déploiement dédié par site ; pas de couche framework CI, pas d'orchestrateur, pas de Docker dans l'artefact.
---
# https://mikbry.com/fr/blog/
# Journal
J'écris ici sur le problème qu'on me paie pour résoudre : des apps construites avec l'IA qui marchent en démo et ne sont pas forcément sûres avec de vrais utilisateurs, de vrais paiements, de vraies données. Pas de discours d'expert — chaque article part d'une question qu'un fondateur se pose vraiment et se termine par une décision qu'il peut prendre.
J'explique les détails techniques quand ils affectent une décision. Les questions sont en général simples : est-ce que ça peut perdre les données d'un client, prendre le mauvais paiement, bloquer quelqu'un dehors, ou casser sans retour arrière possible ?
Les sujets vont des risques fournisseurs aux post-mortems d'incidents, en passant par ce que couvre vraiment une checklist de mise en production — pas de battage IA, des problèmes que les fondateurs rencontrent vraiment.
---
# https://mikbry.com/fr/hello-world/
# Hello, World de l'ère de l'IA
Vous avez une idée à construire. Elle vous trotte peut-être dans la tête depuis des mois. Vous n'avez pas écrit une seule ligne de code — et à l'ère de l'IA, vous ne savez pas trop combien il vous en faudra. C'est exactement le bon moment pour faire le premier pas.
Vous avez déjà construit quelque chose ? Commencez plutôt par le [Trust Scan gratuit](/pret-a-lancer/) — même approche privée et sans envoi, mais pour les fondateurs qui ont déjà du code.
Avant de dépenser quoi que ce soit dans la construction, passez cinq minutes à examiner l'idée elle-même. L'**Idea Scan** est une lecture gratuite, notée sur une grille : par quoi commencer, quoi laisser de côté, et où votre attention compte le plus dès maintenant.
## Qu'est-ce qu'un Idea Scan ?
Cinq minutes de saisie — votre idée, votre cible, le problème, ce que vous avez déjà essayé — renvoient une note de constructibilité de A à D sur six catégories (Clarté, Périmètre, Réalisme, Singularité, Constructibilité, Centrage utilisateur) et les trois points qui méritent le plus votre attention. On note si l'idée peut être bien construite, pas si elle rapportera. Gratuit toujours, un par idée par e-mail.
## Et si j'ai une bonne idée mais que je n'ai encore rien commencé ?
Alors cette page est écrite pour vous. L'Idea Scan vous donne une note et des prochaines étapes calées sur cette note. À partir de là, trois portes s'ouvrent : le premier cours si vous voulez apprendre la méthode, l'accès étagé à **Marabot Idea** si vous voulez un compagnon qui vous accompagne semaine après semaine, ou un **Day-0 Plan** payant si vous voulez une heure avec Mik avant d'engager le premier euro dans la construction. Prenez celle qui colle à votre situation réelle.
## Avez-vous besoin de voir mon code ?
Non. L'Idea Scan porte sur l'idée, pas sur le code — il n'y a pas encore de code, et c'est justement l'intérêt. Plus tard, quand du code existera, la règle tient : aucun accès à quoi que ce soit — ni à votre dépôt, ni à votre application en ligne, ni à votre base de données. On travaille avec ce que vous choisissez d'envoyer. Rien d'autre.
L'Idea Scan n'est pas encore ouvert — il ouvre dans le cadre du déploiement par étapes de Marabot Idea. Inscrivez-vous à la liste ci-dessous, vous serez prévenu·e dès l'ouverture de votre étape. Le premier cours et le Day-0 Plan sont ouverts en parallèle ; prenez celle des trois portes qui vous correspond le mieux.
---
# https://mikbry.com/fr/
# Mik Bry — CTO à temps partagé & Bâtisseur IA
## 01 — Ce que j'audite
Une démo qui tourne répond à une seule question : est-ce que ça marche ? Elle ne dit rien sur le fait de la mettre entre les mains d'inconnus avec leur argent et leurs données. Je regarde la partie qu'on ne voit pas en cliquant sur les boutons.
Architecture · Authentification & sécurité · Modèle de données · Paiements · Déploiement · Tests · Observabilité · Qualité du code généré par l'IA
## 02 — Ce que vous recevez
Vous n'obtenez pas un score pass/fail. Je vous montre ce qui est prouvé, ce qui est supposé, ce qui bloque vraiment le lancement, et ce qui peut attendre.
Vous obtenez les risques que j'ai trouvés, et un plan pour chacun : corriger, différer, ou surveiller.
## 03 — Comment ça marche
Je passe le code moi-même. Pas de score automatisé à la place d'une lecture humaine.
**01 — Revue technique**
J'inspecte l'architecture, le code, le modèle de données, l'infrastructure et les façons dont ça peut casser une fois les vrais utilisateurs arrivés.
**02 — Cartographie des risques**
Vous obtenez une vue claire de ce qui est sûr, fragile, manquant ou bloquant.
**03 — Plan de durcissement**
Nous priorisons ce qu'il faut corriger maintenant, différer, ou surveiller après le lancement.
**04 — Accompagnement CTO fractionné**
Si besoin, j'aide à exécuter le plan — pas juste vous le remettre et disparaître.
Je n'envoie votre code source complet nulle part. Si un outil a besoin d'un extrait, je ne l'envoie qu'après votre accord.
J'ai écrit plus en détail sur pourquoi une démo qui tourne n'est pas la même promesse qu'un lancement prêt, sur [le blog](/fr/blog).
---
# https://mikbry.com/fr/privacy/
# Confidentialité
## 01 — La version courte
Ce site ne vous piste pas. Il compte les pages vues et les clics sur les boutons
sous forme de totaux horaires anonymes — le même comptage qu'on tiendrait avec une
feuille de papier. Aucun cookie de mikbry.com, aucun pixel espion, aucune analyse
via Google, Meta ou qui que ce soit d'autre, et aucun compte requis pour naviguer.
Si vous décidez de nous envoyer votre idée (Idea Scan) ou votre code (Trust
Report), c'est une action explicite de votre part — pas quelque chose que nous
observons se produire.
## 02 — Hébergement et journaux
Le site est servi en fichiers statiques depuis un VPS Scaleway en France, derrière
Caddy (un serveur web écrit en Go). Comme tout hébergeur, Caddy enregistre des
journaux de requêtes standard — adresse IP, horodatage, URL demandée et agent
utilisateur — pour la diffusion, la sécurité et la prévention des abus. Ces journaux
sont conservés **7 jours**, consultés uniquement en cas d'incident à analyser, puis
supprimés. Nous ne les agrégeons pas en un profil de vous.
## 03 — Ce que nous comptons, exactement
Quand une page se charge, votre navigateur envoie à notre serveur un petit message
qui dit « quelqu'un a chargé /about à 15 h, heure de Paris ». Quand vous cliquez sur
l'un de nos boutons, votre navigateur envoie « quelqu'un a cliqué sur le bouton Trust
Report à 15 h, heure de Paris ». C'est tout. Nous ne stockons ni votre adresse IP, ni
votre type de navigateur, ni la taille de votre écran, ni votre langue, ni aucun
identifiant qui permettrait de distinguer votre visite de celle du suivant. Nous ne
voyons jamais que des totaux horaires agrégés. C'est assez pour savoir si une page
est utile ; ce n'est pas assez pour savoir si vous êtes venu.
## 04 — Do Not Track et Global Privacy Control
Ce site ne pose aucun cookie de pistage et ne fait tourner aucun traceur tiers à
désactiver — il n'y a donc rien en coulisses qu'un signal Do Not Track (DNT) ou
Global Privacy Control (GPC) envoyé par votre navigateur changerait de façon
observable. Nous considérons que c'est respecter le signal par construction plutôt
que par un script qui lit un en-tête : si nous ajoutons un jour une fonctionnalité
qui regarderait DNT ou GPC, elle refusera de pister quel que soit le signal, pas
l'inverse. Un résumé lisible par machine de cette posture se trouve sur
[/.well-known/privacy.json](/.well-known/privacy.json).
## 05 — IA et transparence éditoriale
Le contenu de ce site est écrit par un humain. Mik utilise des outils d'IA — Claude
Code et Cursor — dans le flux de code et d'édition comme levier d'accélération sous
revue humaine, jamais comme auteur autonome. Les notes de la série « build »
paraissent sur la page [/about](/fr/about).
## 06 — Le service Trust Report
Si vous choisissez de lancer un Trust Report sur votre code, l'analyse se déroule
**dans votre navigateur**. Le Scan n'a accès à rien : ni à votre dépôt (aucune
connexion GitHub ou GitLab, aucun clone, aucun envoi), ni à votre application en
production (aucun scan d'URL, aucune sonde d'exécution), ni à votre base de données
(aucun identifiant de connexion, aucune requête). Votre code ne quitte jamais votre
ordinateur ; aucun serveur n'en voit une seule ligne.
Quand vous décidez de recevoir votre rapport PDF, votre navigateur n'envoie que le
résultat de l'analyse (scores, catégories, texte des preuves — pas de code, pas de
chemins de fichiers) à notre service de livraison sur `service.mikbry.com`. Vous
pouvez choisir d'anonymiser ce résultat avant qu'il ne quitte votre navigateur — en
retirant le nom de votre projet et tout identifiant résiduel — via une case à cocher
en un clic à l'étape de consentement. Le service de livraison génère votre PDF, vous
l'envoie par e-mail, puis supprime automatiquement le résultat envoyé et le PDF
produit dans les 30 jours suivant la livraison. Par défaut, rien de votre code, de
votre application ou de votre activité n'est conservé sur nos serveurs.
Les scanners par URL peuvent observer des en-têtes et des réponses en production
qu'une analyse locale dans le navigateur ne voit pas.
## 07 — Vos droits
En vertu des articles 15 à 22 du RGPD, vous disposez d'un droit d'**accès** aux
données que nous détenons sur vous, de **rectification** si elles sont erronées,
d'**effacement**, de **limitation** du traitement, de **portabilité** vers une copie
exportable, et d'**opposition** à un traitement avec lequel vous êtes en désaccord.
Pour la plupart des visiteurs, la conversation est courte : les compteurs de trafic
horaires anonymes ne portent aucun identifiant permettant de vous retrouver — il n'y
a donc rien à exporter ni à supprimer de ce côté-là. Si vous avez un compte, ou si
vous avez envoyé un Idea Scan ou un Trust Report, écrivez à
[hello@mikbry.com](mailto:hello@mikbry.com) et nous traiterons votre demande
directement — pas de système de tickets, pas de sous-traitant intermédiaire.
## 08 — Quand vous avez un compte
Dès que vous demandez un Idea Scan, souscrivez à une offre ou créez un compte d'une
autre façon, nous suivons votre parcours dans le produit — les pages que vous visitez,
les rapports que vous avez lancés, l'état de votre abonnement. C'est ainsi que nous
améliorons le produit, et vous l'avez accepté à l'inscription. Vous pouvez demander la
suppression de votre compte et de ses données à tout moment en écrivant à
[hello@mikbry.com](mailto:hello@mikbry.com).
## 09 — Contact
Des questions sur la confidentialité ? Écrivez à
[hello@mikbry.com](mailto:hello@mikbry.com).
---
# https://mikbry.com/fr/projects/
# Projets
## 01 — Travaux sélectionnés
Ces produits IA et missions logicielles montrent ma façon de travailler comme CTO opérationnel : de la définition produit et l'architecture à la livraison sécurisée et l'exploitation.
### Kynto — CTO opérationnel
*Déc. 2025 – Mars 2026 · Paris · SaaS B2B de recrutement augmenté par l'IA*
Pour Kynto, j'avais trois mois pour passer des maquettes Figma à une plateforme de recrutement en production. J'ai fait tourner quatre agents de code en parallèle, mais j'ai gardé l'authentification, l'isolation multi-tenant, les paiements et le cycle de vie des données sous revue humaine. On a livré en trois mois — tableau de bord temps réel, validation hiérarchique des offres, gestion documentaire, création d'offres et matching de CV assistés par IA, synchronisation de calendriers, et un cycle de vie des données pensé RGPD dès le départ (export + suppression automatique à 24 mois).
Détails techniques
- **Stack :** Next.js 15, React 19, TypeScript, Tailwind, PostgreSQL + Drizzle, Better Auth (multi-tenant), AWS S3, Vercel CI/CD, Vertex AI agents, Stripe, Google/Microsoft Calendar, Lemlist.
- **Échelle :** 300+ fichiers, 40K+ lignes, 17 tables relationnelles, 55 composants UI, 40+ endpoints API validés par Zod, 790+ tests Vitest, bilingue FR/EN (13 namespaces).
- **Fonctionnalités :** upload S3 avec suivi de progression, synchronisation Google/Microsoft Calendar.
- **Sécurité :** authentification par session, URLs S3 présignées, isolation des tenants via requêtes paramétrées Drizzle, OAuth 2.0 pour les calendriers.
- **Méthode :** Claude Code (CLI Anthropic) pilotant 4 agents de code IA en parallèle, du Figma à la production en 3 mois.
### Ballpoint — Développeur Rust, R&D honeypot SMB
*Déc. 2025 · Paris · Recherche en cybersécurité*
Ballpoint avait besoin de repérer les attaquants qui ciblent le partage de fichiers Windows avant qu'ils n'atteignent des données réelles. J'ai construit un honeypot qui parle vraiment le protocole SMB — des parseurs zero-copy pour NetBIOS et la négociation de protocole, pas juste un observateur de logs. Pour avoir les détails du protocole justes, j'ai dû lire le code source de Samba et cartographier où se trouvait réellement la surface de personnalisation. Le honeypot journalise et qualifie le comportement d'un attaquant en temps réel, avec des alertes hiérarchisées par gravité pour qu'une équipe de sécurité sache exactement à quoi elle fait face.
Détails techniques
- **Stack :** Rust, Docker, SMB1/2/3, NetBIOS ; testé avec smbclient, nmap, netexec, Wireshark, tcpdump.
- **Échelle :** serveur SMB complet en 3 000+ lignes de code.
- **Fonctionnalités :** parseurs binaires zero-copy pour NetBIOS et la négociation de protocole, alertes hiérarchisées par gravité (inspirées d'OpenCanary), rapports d'alerte HTML + JSON, environnements Docker multi-configurations pour la validation des protocoles, analyse PCAP.
- **Méthode :** audit du code source C de Samba pour cartographier la surface de personnalisation et d'extension de SMB2/3 — avec une note technique sur les voies de personnalisation (configuration vs. modification de code, contraintes GPL).
### PlanWork.ai — CTO
*Depuis juil. 2025 · Clermont-Ferrand · Assistant IA pour la rénovation et la construction*
PlanWork.ai aide les propriétaires à transformer une vieille maison en lieu de vie idéal, avec un assistant IA pour planifier, budgéter et suivre les travaux. J'ai commencé par le produit lui-même : pour qui, ce dont la première version payante avait vraiment besoin, et ce qui pouvait attendre. Ensuite j'ai construit l'infrastructure SaaS, connecté l'IA, et lancé le premier abonnement Stripe.
Détails techniques
- **Stack :** OpenAI, AWS, Vercel, Next.js, PostgreSQL.
### iliadata — Tech lead
*Depuis fév. 2025 · Paris · Plateforme de cryptographie*
J'ai porté iliadata de la spécification à une plateforme de cryptographie en production. La difficulté : protéger l'authentification, le chiffrement et le stockage sans rendre le système impossible à exploiter. D'où une architecture distribuée — une bibliothèque cryptographique en C compilée en WebAssembly, communiquant avec le backend via WebRTC et WebSocket.
Détails techniques
- **Stack :** React, TypeScript, Tailwind, Shadcn/ui, Node.js, Python/FastAPI, WebRTC, WebSocket, C compilé en WebAssembly via Emscripten, Docker Compose, Scaleway, GitHub Actions.
- **Fonctionnalités :** architecture distribuée — un client et un backend multi-services avec communications sécurisées ; P2P via WebRTC et WebSocket ; bibliothèque cryptographique en C compilée en WebAssembly et appelée depuis un WebWorker.
- **Sécurité :** intégration SHA-256 / AES, authentification Keycloak, chiffrement homomorphe, stockage sécurisé.
- **Méthode :** DevOps complet — Docker Compose multi-conteneurs, déploiement Scaleway automatisé, CI GitHub Actions.
### Televista — CTO
*Fév. 2025 – Nov. 2025 · Paris · SaaS d'affichage dynamique*
Pour Televista, j'ai écrit la spécification et la réponse à l'appel d'offres public pour un SaaS d'affichage dynamique, puis construit le MVP lui-même — lecteur vidéo et outils d'administration — qui devait tenir ce que l'appel d'offres promettait.
Détails techniques
- **Stack :** Next.js sur Vercel et Azure, lecteur vidéo, outils de traitement de données en Python.
- **Sécurité :** Better Auth, RGPD, conformité accessibilité et sécurité.
- **Méthode :** développement avec Cursor et Claude Code de bout en bout ; génération vidéo/image avec Flux, Midjourney et d'autres.
### Dylaw — CTO opérationnel
*Janv. 2025 – Oct. 2025 · Paris · SaaS de services juridiques augmenté par l'IA*
Dylaw devait sortir vite, mais l'app gérait des avocats, des documents, des paiements — un prototype rapide n'aurait pas suffi. J'ai livré la première version en deux à trois mois, contre six à huit habituellement, en traitant l'authentification, les données et les paiements comme du travail de production dès le départ.
Profils d'avocats, mise en relation client–avocat, messagerie temps réel, gestion documentaire, prise de rendez-vous, facturation et paiements, tableaux de bord analytiques, et assistants IA conversationnels avec automatisation des flux juridiques.
Détails techniques
- **Stack :** site marketing (Next.js, SEO), application SaaS (React), panneau d'administration, API REST (Node.js, PostgreSQL), services IA (Python).
- **Échelle :** crawler CNB — collecte automatisée sur 164 barreaux français et 78 536+ avocats, avec mises à jour mensuelles.
- **Méthode :** développement assisté par IA avec Cursor.
### Opla — Fondateur, développeur principal
*Depuis janv. 2024 · Clermont-Ferrand · Assistants IA locaux*
J'ai lancé Opla parce que je voulais des assistants IA locaux qui n'envoient vos données nulle part. Le modèle tourne sur votre propre ordinateur, point final.
Détails techniques
- **Stack :** Rust, TypeScript, Next.js, Tauri, WebAssembly, WebGPU.
- **Fonctionnalités :** solutions IA locales et sécurisées avec builds desktop multiplateformes ; bibliothèques et applications multiplateformes bâties sur WebAssembly et WebGPU.
### Storyfox — CTO opérationnel
*Juin 2021 – Fév. 2023 · Paris · SaaS vidéo*
Chez Storyfox, j'ai dirigé l'équipe, recruté des profils seniors, planifié la roadmap et gardé la sécurité dans le travail de livraison. Mon rôle : transformer les demandes métier en choses que l'équipe pouvait vraiment livrer.
Détails techniques
- **Stack :** React.js, React Native, MongoDB, AWS, GCP, traitement vidéo, ML.
## 02 — Open source
- Un outil d'orchestration que je construis pour faire tourner plusieurs agents de code IA en parallèle sur des worktrees git — un ticket par agent, un merge séquentiel. *(Open source bientôt.)*
- [Opla](https://github.com/Opla/opla) — plateforme open source d'assistants IA locaux et respectueux de la vie privée.
- [awesome-webgpu](https://github.com/mikbry/awesome-webgpu) — liste sélectionnée de ressources WebGPU.
---
# https://mikbry.com/blog/ai/arreter-tout-relire-code-ia/
# J'ai arrêté d'essayer de relire la production d'une armée de robots
Mik Bry · 2026-07-21 · lecture ~9 min · IA
Pendant des années, une bonne partie de mon travail ressemblait à ça : ajouter un `console.log`, recharger la page, regarder le résultat, et marmonner quelque chose que je ne mettrais pas dans un article destiné à mes clients.
J'adorais ça. Déboguer, c'est une enquête. On construit une théorie, on teste, et la confusion devient une réponse qu'on peut défendre. Mes clients, eux, aimaient beaucoup moins. Ils payaient pour une fonctionnalité qui marche, pas pour les heures passées à comprendre pourquoi le programme ne faisait pas ce qu'on attendait de lui.
Puis l'IA est devenue assez bonne pour écrire une bonne partie de ce code à ma place. Moins d'heures devant les logs. Problème réglé ?
Pas vraiment.
Dans cet article
1. [Quand la machine a cessé d'être le goulot](#s1)
2. [Rien de nouveau — juste beaucoup plus vite](#s2)
3. [Le goulot n'a jamais été la vitesse de frappe](#s3)
4. [Programmer n'a jamais été tout le métier](#s4)
5. [Automatiser la vérification, garder la responsabilité](#s5)
6. [Ce que je vends est en train de changer](#s6)
01 — Quand la machine a cessé d'être le goulot
Avec un assistant de code, je décris une fonctionnalité et je reçois une implémentation plausible en quelques minutes. Il ne se fatigue jamais, ne perd jamais patience, n'a jamais besoin d'aller marcher dix minutes pour débloquer une fonction récalcitrante.
Mais la responsabilité de ce qui part en production reste exactement là où elle a toujours été : sur moi. Je dois toujours comprendre l'architecture, repérer la mauvaise hypothèse cachée trois fichiers plus loin, vérifier qu'un test prouve vraiment quelque chose plutôt que de simplement s'exécuter, et pouvoir expliquer le résultat à qui paie la facture.
L'assistant produisait les cent lignes suivantes avant que j'aie fini de comprendre les cent précédentes.
Je n'avais pas supprimé le goulot d'étranglement. Je l'avais déplacé — de taper du code à le reconstruire mentalement, une pull request plausible après l'autre. Et contrairement à moi, ce qui produisait ces pull requests n'avait pas besoin de dormir.
02 — Rien de nouveau — juste beaucoup plus vite
Il y a aussi quelque chose d'étrangement familier dans le fait de coder avec l'IA.
Le code ne donne pas l'impression de venir d'une autre planète. La plupart du temps, il ressemble à du code que j'ai déjà vu — les mêmes patterns, les mêmes raccourcis, les mêmes abstractions, les mêmes idées astucieuses et les mêmes mauvaises hypothèses que je croise chez des développeurs humains depuis des décennies.
Logique. Ces systèmes ont appris sur une masse énorme de logiciels écrits par des humains. Travailler avec eux ressemble moins à rencontrer une nouvelle espèce qu'à travailler avec une équipe de développement incroyablement rapide.
La différence, c'est l'échelle.
Un développeur peut m'envoyer une pull request en fin d'après-midi. Un agent peut produire l'équivalent de plusieurs pull requests pendant que je réfléchis encore à la première. Lancez plusieurs agents en même temps, et la quantité de travail plausible qui arrive à relire peut dépasser ce qu'une seule personne peut vraiment absorber.
Cette sensation-là aussi, je la connais.
Pendant les périodes de rush, bien avant les agents de code, une équipe pouvait déjà produire des changements plus vite que quiconque ne pouvait vraiment les relire. On finissait fatigué, à changer de contexte en permanence, à valider des choses avec moins de compréhension qu'on ne l'aurait voulu.
L'IA n'a pas inventé ce problème. Elle a juste supprimé la limite de vitesse humaine d'un seul côté de l'équation.
Si on essaie de compenser en lisant plus vite et en surveillant tout, on finit par se griller le cerveau.
La solution, c'est la même leçon que les bonnes organisations d'ingénierie avaient déjà apprise avant l'IA : structurer le travail pour que l'attention humaine se dépense là où elle change vraiment le résultat.
03 — Le goulot n'a jamais été la vitesse de frappe
Voici ce que j'ai mis du temps à admettre : la contrainte n'a jamais été la vitesse d'écriture du code. C'était la quantité d'attention que chaque façon de travailler me coûtait — et ce qu'il en restait pour les choses qui avaient vraiment besoin d'un humain. Toute façon de construire un logiciel est en fait un pari sur la quantité d'attention humaine qu'elle consomme. Celle qui gagne est celle qui en dépense le moins sur le routinier, pour qu'il en reste pour ce qui compte.
Coder à la main consomme de l'attention à taper et à se souvenir. L'IA sous revue humaine permanente en consomme à relire la production de quelqu'un — ou de quelque chose — d'autre, plus vite que la compréhension ne peut suivre. Aucune des deux n'est gratuite. La bonne question à poser sur une méthode de travail n'est pas sa vitesse. C'est où va l'attention, et si c'est bien là qu'elle devrait aller.
Aujourd'hui, je fais tourner un système qui coordonne plusieurs agents de code : il découpe un objectif en tâches, les distribue, exige des tests et une revue par un agent séparé avant toute fusion, et garde une trace de ce qui s'est passé et pourquoi. Un système interne, rien à installer — moins une armée qu'un chef de chantier qui ne laisse jamais une équipe repartir sans avoir noté ce qui a été fait.
Ce qui a vraiment changé, ce n'est pas la vitesse. C'est ce qui me parvient. Au lieu de lire chaque ligne générée, je vois l'objectif, ce qui a été testé et ce qui a échoué, une revue par un agent séparé, tout ce qui ressemble à un conflit d'intégration, et la poignée de décisions qui touchent à l'argent, à l'architecture ou aux données d'un client. Le reste, le routinier, est vérifié par quelque chose qui n'est pas un humain à bout à 23h. J'ai arrêté d'utiliser mon attention pour surveiller en permanence ce que les agents produisent.
Une partie peut tourner pendant que je dors parce que les tests permettent de la valider automatiquement. Une autre ne peut pas, parce que seul mon jugement le peut — et savoir laquelle est laquelle, c'est à peu près tout le métier. Lors d'une exécution récente, un agent a terminé l'essentiel d'une implémentation testée pendant la nuit. Le lendemain matin, j'ai surtout vérifié que l'objectif tenait toujours et lu les preuves laissées derrière lui — pas relu chaque ligne écrite.
04 — Programmer n'a jamais été tout le métier
La conséquence étrange, c'est que je passe aujourd'hui moins de mon temps à programmer — et davantage à faire les autres parties du métier qui ont toujours été là.
L'architecture. Comprendre le produit. Décider ce qui doit être construit. Lire des systèmes qu'on ne connaît pas. Apprendre vite une nouvelle technologie. Penser à la sécurité et aux coûts. Concevoir les tests. Enquêter sur le comportement en production. Expliquer les compromis. Décider si un raccourci est inoffensif ou va coûter cher dans six mois.
Aucune de ces responsabilités n'est apparue avec l'IA. Elles faisaient déjà la différence entre un ingénieur expérimenté et quelqu'un qui sait simplement écrire du code.
Mais il y avait un problème commercial : en tant qu'indépendant, **ce que je vendais, c'était la programmation**.
Un client comprend « cinq jours de développement ». Il comprend une fonctionnalité, un sprint, un taux journalier. L'architecture, le jugement, la réduction des risques et le fait de savoir ce qu'il ne faut *pas* construire, c'est plus difficile à mettre sur une facture.
L'IA est en train de forcer ce modèle à changer.
Si un agent peut produire en une heure ce qui me prenait une journée à taper, facturer avant tout le temps que je passe à écrire l'implémentation a de moins en moins de sens.
Ma valeur se déplace vers ce que cette implémentation plus rapide rend plus important : décider ce qui mérite d'être construit, structurer le système autour, trouver ce que l'automatisation a manqué, et décider si le résultat mérite qu'on lui fasse confiance.
05 — Automatiser la vérification, garder la responsabilité
Je pensais que la vraie ligne de partage était humain contre IA. Ce n'est pas ça. J'ai vu du code généré par IA mieux testé que du code que j'avais écrit moi-même dans l'urgence, et j'ai vu des pull requests « relues » tamponnées par quelqu'un d'aussi fatigué que je l'étais à 23h.
La distinction qui compte vraiment, ce n'est pas humain contre IA. C'est ce qui est vérifié de façon systématique et ce qui ne l'est pas. Vérifier ne veut pas dire qu'un humain relit chaque ligne : les contrôles de routine peuvent être automatisés et reproductibles, tant qu'une personne identifiée reste responsable des décisions difficiles à annuler.
06 — Ce que je vends est en train de changer
C'est une des raisons pour lesquelles j'ai commencé à construire le **Trust Report**.
Ce n'est pas une tentative de vendre de la relecture de code à l'heure. Le système automatisé fait l'analyse répétitive. Mon travail consiste de plus en plus à construire la méthode autour : ce qu'il faut vérifier, quelles preuves comptent, quels risques méritent d'être remontés, et quand la réponse d'une machine a besoin d'un contexte humain.
Autrement dit, le logiciel prend en charge de plus en plus du travail de programmation. Moi, je vends de plus en plus le jugement qui l'entoure.
Le système que j'utilise garde plus que le code. Pour n'importe quel changement, il peut me montrer la trace des décisions sur à peu près les 200 derniers commits — pas tout l'historique depuis le début, juste assez de mémoire de travail pour répondre à la seule question qui intéresse vraiment un client. Pas quelle fonction un agent a touchée. Pourquoi le changement était nécessaire, ce qui a été vérifié, et ce qui se passe si c'est faux.
Je ne peux pas taper plus vite qu'une armée de robots, et j'ai arrêté d'essayer de tout relire à la main derrière elle. Ce que je peux encore faire, c'est décider des règles sous lesquelles elle travaille, et garder assez de traces pour expliquer, à un autre humain, pourquoi le résultat mérite d'être cru.
Si vous voulez aller plus loin
Je relis des applications construites avec l'IA ou en vibe coding avant leur mise en production.
Commencer ici
Trust Report
Une revue automatisée de votre app et de son code, réalisée avec mes outils d'analyse. Vous obtenez les principaux risques, ce qui mérite l'attention avant le lancement et ce qui peut attendre. Si vous souhaitez parcourir les résultats ensemble, une revue avec moi est disponible en option.
Architecture, paiements, accès, données clients, garde des clés de déploiement, logiciels tiers, et une recommandation de mise en production documentée par un CTO humain.
---
# https://mikbry.com/blog/ai/ai-code-review-human-bottleneck/
# I stopped trying to out-review a robotic army
Mik Bry · 2026-07-21 · ~9 min read · AI

For years, a good chunk of my job looked like this: add a `console.log`, reload, stare at the output, and mutter something I wouldn't put in a client-facing blog post.
I loved that part. Debugging is detective work — you build a theory, run a small experiment, and watch confusion turn into an answer you can defend. My clients, understandably, loved it less. They were paying for a working feature, not for the hours I spent reconstructing what a program secretly believed about itself.
Then AI got good enough to write a lot of that code for me. Fewer hours staring at logs. Problem solved?
Not quite.
In this piece
1. [When the machine stopped being the bottleneck](#s1)
2. [I've seen this before — just not at this speed](#s2)
3. [The bottleneck was never the typing](#s3)
4. [Programming was never the whole job](#s4)
5. [Verified by system, owned by a human](#s5)
6. [What I sell is changing](#s6)
01 — When the machine stopped being the bottleneck
With a coding assistant, I describe a feature and get a plausible implementation in minutes. It never gets tired, never loses patience, never needs to go for a walk to untangle a stubborn function.
But the responsibility for what ships stayed exactly where it always was: on me. I still had to understand the architecture, catch the wrong assumption buried three files deep, check that a test actually proved something instead of just running, and be able to explain the result to whoever was paying for it.
The assistant could generate the next hundred lines before I'd finished making sense of the last hundred.
I hadn't removed the bottleneck. I'd relocated it — from typing code to reconstructing it in my head, one plausible-looking pull request at a time. And unlike me, whatever was producing those pull requests didn't need to sleep.
02 — I've seen this before — just not at this speed
There is also something strangely familiar about coding with AI.
The code does not feel like it came from another planet. Most of the time it looks like code I have seen before — the same patterns, shortcuts, abstractions, clever ideas and occasional bad assumptions I have seen from human developers for decades.
That makes sense. These systems learned from an enormous body of software written by people. Working with them often feels less like meeting a new species and more like working with an impossibly fast development team.
The difference is scale.
A developer can send me a pull request at the end of the afternoon. An agent can produce the equivalent of several of them while I am still thinking about the first one. Run several agents at once and the amount of plausible work arriving for review can exceed what one person can meaningfully absorb.
I recognise that feeling too.
During crunch periods, long before coding agents existed, a team could produce changes faster than anybody could properly review them. You ended up tired, context-switching constantly, approving things with less understanding than you wanted.
AI did not invent that failure mode. It removed the human speed limit from one side of it.
If you try to compensate by reading faster and watching everything, you eventually fry your brain.
The solution is the same lesson good engineering organisations learned before AI: structure the work so that human attention is spent where it changes the outcome.
03 — The bottleneck was never the typing
Here's the part that took me longer to admit than I'd like: the constraint was never how fast code got written. It was how much of my attention any given way of building spent — and how much it left over for the parts that actually needed a human. Every way of building software is really a bet about how much human attention it spends. The winner is whichever one spends the least on the routine, so there's more left for what matters.
Coding by hand spends attention on typing and recall. AI under constant human review spends it on re-reading someone — or something — else's output, fast enough that understanding never quite catches up. Neither is free. The useful question about any workflow isn't how fast it is. It's where the attention goes, and whether that's where you want it.
Today I run something that coordinates a handful of coding agents: it splits an objective into pieces of work, hands them out, requires tests and a separate agent review before anything merges, and keeps a record of what happened and why. An internal system, nothing you'd install — think of it less as a swarm and more as a foreman who never lets a shift end without a log of what was done.
The part that actually changed wasn't speed. It was what reaches me. Instead of reading every generated line, I see the objective, what passed and what failed, a separate agent review, anything that smells like an integration conflict, and the handful of decisions that touch money, architecture, or a customer's data. Everything routine gets checked by something that isn't a human running on fumes at 11pm. I stopped using my own attention as a polling loop.
Some of that work can run while I sleep, because a test suite is willing to check it for me. Some of it can't, because only my judgment can — and knowing which is which turned out to be most of the actual skill. In one recent run, an agent finished most of a tested implementation overnight. My active time the next morning went into confirming the target was still the right one and reading the evidence it had left behind, not re-reading every line it had written.
04 — Programming was never the whole job
The strange consequence is that I now spend less of my day programming — and more of it doing the other parts of the job that were always there.
Architecture. Understanding the product. Deciding what should be built. Reading unfamiliar systems. Learning a new technology quickly. Thinking about security and cost. Designing tests. Investigating production behaviour. Explaining trade-offs. Deciding whether a shortcut is harmless or will become expensive six months later.
None of those responsibilities appeared with AI. They were already most of what distinguished an experienced engineer from someone who could simply write code.
But there was a commercial problem: as a freelancer, **programming was the thing I sold**.
A client could understand "five days of development." They could understand a feature, a sprint, a day rate. Architecture, judgment, risk reduction and knowing what *not* to build were harder to put on an invoice.
AI is forcing that model to change.
If an agent can produce in an hour what used to take me a day to type, charging primarily for my ability to type the implementation makes less and less sense.
My value moves toward the things the faster implementation makes more important: deciding what deserves to be built, structuring the system around it, finding what the automation missed, and deciding whether the result deserves to be trusted.
05 — Verified by system, owned by a human
I used to think the real split was human-built versus AI-built. It isn't. I've seen AI-generated code better tested than something I wrote myself in a hurry, and I've seen "reviewed" pull requests rubber-stamped by someone as tired as I used to be at 11pm.
The distinction that actually holds up isn't human-built versus AI-built. It's what gets checked systematically and what doesn't. Verification doesn't mean a human reads every line. Routine checks can be automated and repeatable, as long as a named person still owns the decisions that are hard to undo: payments, access to customer data, and what gets deployed tonight.
06 — What I sell is changing
That is one of the reasons I started building the **Trust Report**.
It is not an attempt to sell code review by the hour. The automated system does the repetitive analysis. My work is increasingly about building the method around it: what should be checked, what evidence matters, which risks deserve escalation, and when a machine's answer needs human context.
In other words, the software does more of the programming. I increasingly sell the judgment around the software.
The system I use keeps more than the code. For any change, it can show me the decision trail across roughly the latest 200 commits — not the entire history since the beginning, just enough working memory to answer the question a client actually cares about. Not which function an agent touched. Why the change was necessary, what was checked, and what happens if it's wrong.
I can't out-type a robotic army, and I've stopped trying to out-review one by hand. What I can still do is decide the rules it works under, and keep enough of a paper trail to explain, to another human, why the result deserves to be trusted.
If you want to go further
I review AI-built and vibe-coded applications before they go into production.
Start here
Trust Report
An automated review of your app and its code, using my analysis tools. You get the main risks, what deserves attention before launch, and what can wait. If you want to discuss the findings, a review with me is available as an option.
---
# https://mikbry.com/blog/ai/ai-built-app-five-launch-boundaries/
# Your AI-built app works. But is it ready to launch?
Mik Bry · 2026-07-22 · ~9 min read · AI · Security
I've sat with founders at the exact moment they reach for the deploy button. The app works — pages load, sign-up works, a payment form appears — and for a few seconds that feels like enough. It never is. The demo answers one question: does the expected path work? What I actually get asked to answer is harder: what happens the moment someone stops following that path — a payment notification that fires twice, an identifier changed in the URL, a database write that fails halfway through at 3am on a Sunday?
A demo shows you the expected path works. Production starts the moment users step off it.
I'm not going to pretend AI is bad at writing or testing code. It's getting genuinely good at both — give it a task with a clear right answer, and it checks its own work faster than a person can. What it can't do is decide whether your payment flow stays safe across weeks of real traffic, or whether every code path really blocks the wrong customer from someone else's data. Those aren't pass/fail tests — they're judgment calls about risk, made by someone who can still be asked, later, why they made that call.
A test suite can check known cases. It cannot certify every live outcome, or decide whether the risk that's left over is one you should accept. A named human still owns that decision.
In a small comparison I ran between public AI-built projects and projects that went through my own review process, on similar small-scale work — mostly small backend services, nothing exotic — almost none of the public projects automatically re-checked themselves before a change went live. Mine consistently did. The gap was in the part a founder can't see by clicking around: whether anything would have caught a change that quietly broke something.
What this article covers
1. [Five areas where I still want a human decision](#s1)
2. [Approval is not a magic shield](#s2)
3. [Launch is only the beginning](#s3)
4. [Trust Report and Audit](#s4)
Five areas where I still want a human decision
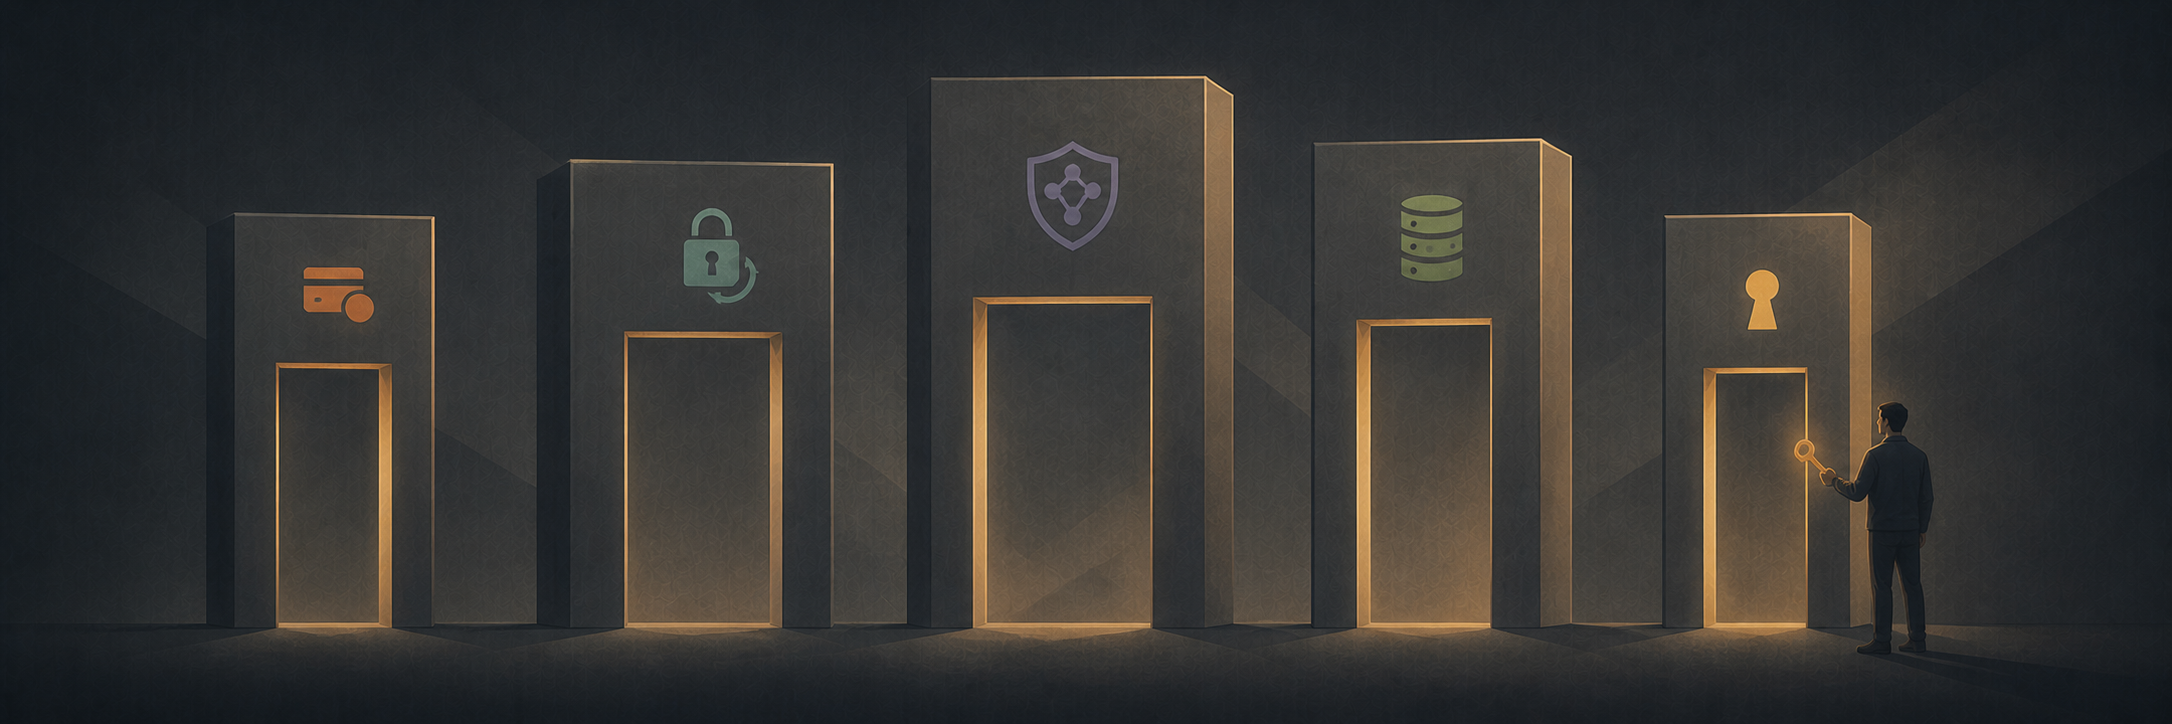
Not every change deserves this much attention. Fixing a typo isn't the same as touching money. These five places are where a mistake gets expensive or hard to take back. If you want the compressed, six-question version of the same discipline, [Six things I check before trusting an AI-built app in production](/blog/ai/six-ai-built-app-red-flags) is the companion checklist.
### 1. Payments
Charged twice for the same order. A card charged with no confirmation email. Live keys switched on by accident while testing. None of that shows up in a single successful checkout — which is usually the only checkout anyone actually tests. Has anyone actually watched what happens when a payment fails halfway through? Stripe's own [go-live checklist](https://docs.stripe.com/get-started/checklist/go-live?locale=en-GB) exists precisely because most teams haven't. If it goes wrong, customers get charged the wrong amount, or twice, and you hear about it from an angry email before you see it in any dashboard.
### 2. Logging in, and getting back in
Login answers who you are right now. Recovery answers something harder: can you prove it again after forgetting your password — without letting an attacker run the same trick in your place? I've seen recovery flows that felt finished because the reset email worked once in a demo, and nobody had tried resetting a stranger's account using only what's already public about them. [NIST's Digital Identity Guidelines](https://pages.nist.gov/800-63-4/) treat proving identity, session safety, and account recovery as one connected chain, not separate features — and a chain only holds at its weakest link. A well-built login screen with a weak recovery flow is a strong front door next to an unlocked side gate — the door was never the problem. Could someone get into another person's account today using only what's on their public profile? If you don't know, that's the answer.
### 3. What one customer can see of another's
Picture a support ticket that reads: "I can see someone else's invoice when I change a number in the address bar." That's not a hypothetical — it's the single most common thing I find. An app can correctly know *who* someone is and still let them see *someone else's* data, if the permission check is missing on even one request out of hundreds. The [OWASP Authorization Cheat Sheet](https://cheatsheetseries.owasp.org/cheatsheets/Authorization_Cheat_Sheet.html) recommends checking permission on every single request, not just the obvious ones — because the obvious ones are rarely where it breaks. Has anyone deliberately tried to open a different customer's account and confirmed, in writing, that it failed? Keeping one customer's data away from another is the access side of a wider discipline — [Why mikbry.com has no cookie banner](/blog/privacy/no-cookie-banner) covers the collection side: what a site gathers about visitors in the first place, and why less is safer than more.
### 4. Changing the database that holds real data
Could you actually undo this change tonight, or are you assuming you could? That's the honest question, and most teams have never tested the answer — a backup that has never been restored isn't a backup, it's a hope. Database changes are dangerous because the old state is often gone by the time anyone notices a problem — the app keeps writing new data over it. [Google Cloud's migration guidance](https://docs.cloud.google.com/architecture/database-migration-concepts-principles-part-2) recommends testing the change first, backing up the target, and having a real plan to put things back — not just believing one exists. If it goes wrong, customer data is silently corrupted, and the last clean backup nobody's tested is hours old.
### 5. The keys that put code into production
A compromised laptop, or a stolen API key, pushes new code straight to customers. No second pair of eyes, no delay, no undo. That's what the fifth area is about. This one is easy to miss. It also decides whether the other four checks mean anything at all — if anyone with a laptop can push straight to production, none of the above matters. [GitHub environments](https://docs.github.com/en/actions/how-tos/deploy/configure-and-manage-deployments/review-deployments), for one, can require a second person's approval before a deploy runs, and hold back production keys until that happens. Similar controls exist everywhere else; the shape is the same. Could one person, or one agent, push a change straight to production alone, tonight, with nobody else watching?
Approval is not a magic shield
None of this is fixed by bolting an approval button onto a deploy. A rushed reviewer can wave through weak evidence just as easily as an agent can miss it — approval theatre is worse than no approval, because it puts someone's name on a decision nobody actually made without changing the actual risk underneath it.
The approval is worth something when it's backed by a short, honest account, not a hundred-page report nobody reads: what's actually changing, which cases were tested (including the ones meant to fail), who could be affected if it's wrong, what's still unknown, and how to undo it if it goes bad. That's a page, not a book. A named person reads it, understands what's still uncertain, and decides whether the risk that's left is one worth taking.
A Scan can catch known patterns. That's useful. But it can't decide whether the risk left over is acceptable — that's a judgment call, not a computation. The score is evidence, not permission to launch.
Before you flip the switch, five questions worth answering honestly:
- Has anyone tested what happens when a payment fails halfway through?
- Could a stranger get into someone else's account using only public information?
- Has anyone deliberately tried to open another customer's data and confirmed it failed?
- Have you actually tested a restore from backup recently, or just assumed one would work?
- Could one person, or one agent, push straight to production alone?
If any of those is "I don't know," that's not a launch decision. It's a guess wearing a launch decision's clothes.
Launch is only the beginning
Passing these checks does not mean the product is finished.
It means you have removed some of the risks that should not be discovered by your first real customers.
Then the real work starts.
Users will do things you never expected. Payments will fail in ways you did not test. A feature nobody cared about will suddenly matter. Another one you spent a week polishing may barely get used. Costs move, dependencies change, traffic grows unevenly, and every new feature creates another place where something can break.
That is normal.
A successful product is not a straight line from prototype to launch. It is a permanent loop: ship, observe, learn, fix, simplify, ship again.
The goal before launch is not to make the product perfect. It is to make sure the obvious risks are understood, the dangerous ones are controlled, and you have enough visibility to learn safely from what happens next.
Launch readiness gets you to the starting line in better shape.
What happens after that is product work.
Trust Report and Audit
These five areas are the security and access side of the discipline. If you want the money side — what actually makes a bill grow after launch — [What does it cost to launch an AI-built app?](/blog/ai/cost-of-launching-an-ai-built-app) covers it.
Three levels: a free automated Scan, a deeper automated Trust Report, then an Audit combining my tools with a human CTO review.
Before requesting a CTO review, you can start with the [Trust Scan](https://mikbry.com/launch-readiness/) — it runs locally, so your source stays on your machine, and only the excerpts you explicitly approve are ever transmitted. It gives you an automated first read, but it doesn't see your production environment or business context.
### Trust Report — €349
An automated review of your app and its code, using my analysis tools. You get the main risks, what deserves attention before launch, and what can wait. If you want to discuss the findings, a review with me is available as an option.
### Audit — from €1,200
A deeper review covering how the app is built, payments, login and access rights, customer data, production database changes, deploy-key custody, and readiness for production — the same five areas, with my tools plus a human CTO reading, and a documented launch recommendation.
---
# https://mikbry.com/blog/ai/app-ia-production-cinq-frontieres/
# Votre app codée avec l'IA tourne. Mais est-elle prête pour la production ?
Mik Bry · 2026-07-22 · lecture ~9 min · IA · Sécurité

Votre app tourne. Les pages chargent, l'inscription fonctionne, le paiement s'affiche.
C'est une bonne nouvelle. Mais ça ne répond pas encore à la question qui compte avant la production : que se passe-t-il quand quelque chose sort du parcours prévu ?
Un paiement envoyé deux fois. Un identifiant modifié dans une URL. Une sauvegarde qu'on n'a jamais essayé de restaurer.
Je ne vais pas prétendre que l'IA est mauvaise pour écrire ou tester du code. Elle devient très bonne là-dessus. Le problème commence quand il faut décider si le risque qui reste est acceptable.
C'est là que je veux encore un humain responsable de la décision.
Une suite de tests vérifie des cas connus. Elle ne peut ni garantir tous les résultats en conditions réelles, ni décider si le risque restant est acceptable. À la fin, une personne identifiée doit encore assumer cette décision.
Dans une petite comparaison que j'ai menée entre des projets publics construits avec l'IA et des projets passés par ma propre revue, sur des tâches de taille comparable — surtout de petits services backend, rien d'exotique — presque aucun des projets publics ne se re-vérifiait automatiquement avant une mise en ligne. Les miens, si, systématiquement. L'écart se trouvait là où un fondateur ne peut rien voir en cliquant : est-ce que quelque chose aurait rattrapé un changement cassé en douce.
Ce que couvre cet article
1. [Cinq sujets où je veux encore une décision humaine](#s1)
2. [Une approbation ne suffit pas](#s2)
3. [Le lancement n'est que le début](#s3)
4. [Trust Report et Audit](#s4)
Cinq sujets où je veux encore une décision humaine

Toute mise en ligne ne mérite pas la même attention. Corriger une faute de frappe, ce n'est pas pareil que toucher à l'argent. Ces cinq endroits sont ceux où une erreur coûte cher ou devient difficile à annuler. Pour une version plus courte en six vérifications, voir [Les 6 choses que je vérifie avant de mettre une app construite avec l'IA en production](/blog/ai/six-signaux-alerte-app-ia).
### 1. Les paiements
Facturé deux fois pour la même commande. Une carte débitée sans email de confirmation. Des clés live activées par erreur pendant un test. Rien de tout ça n'apparaît dans le seul paiement qu'on teste d'habitude. Quelqu'un a-t-il vraiment observé ce qui se passe quand un paiement échoue à mi-chemin ? La [go-live checklist de Stripe](https://docs.stripe.com/get-started/checklist/go-live?locale=en-GB) existe justement parce que la plupart des équipes ne l'ont jamais fait. Si ça tourne mal, des clients sont facturés du mauvais montant, ou deux fois, et vous l'apprenez par un email furieux avant de le voir dans un tableau de bord.
### 2. Se connecter, et pouvoir revenir
Se connecter, c'est prouver qui on est à l'instant. Récupérer son compte, c'est prouver qu'on est toujours la même personne après avoir oublié son mot de passe — sans qu'un attaquant puisse faire pareil à sa place. J'ai vu des parcours de récupération qu'on croyait terminés parce que l'email de réinitialisation marchait une fois en démo, et que personne n'avait essayé de réinitialiser le compte d'un inconnu avec seulement ce qui est déjà public sur lui. Les [Digital Identity Guidelines du NIST](https://pages.nist.gov/800-63-4/) traitent la preuve d'identité, la sécurité des sessions et la récupération de compte comme une seule chaîne connectée, pas trois fonctionnalités séparées. Un écran de connexion solide avec une récupération fragile, c'est une porte blindée à côté d'un portail resté ouvert — la porte n'a jamais été le problème. Quelqu'un pourrait-il entrer dans le compte d'un autre aujourd'hui avec seulement ce qui est déjà public sur lui ? Si vous ne savez pas, voilà votre réponse.
### 3. Ce qu'un client peut voir d'un autre
Imaginez un ticket de support qui dit : « Je vois la facture de quelqu'un d'autre quand je change un chiffre dans l'adresse. » Ce n'est pas une hypothèse — c'est la chose la plus courante que je trouve. Une app peut savoir correctement *qui* est quelqu'un et quand même lui laisser voir les données de *quelqu'un d'autre*, si la vérification des droits manque sur ne serait-ce qu'une requête sur cent. L'[Authorization Cheat Sheet de l'OWASP](https://cheatsheetseries.owasp.org/cheatsheets/Authorization_Cheat_Sheet.html) recommande de vérifier les permissions à chaque requête, pas seulement les évidentes — parce que ce sont rarement les évidentes qui cassent. Est-ce que quelqu'un a volontairement essayé d'ouvrir le compte d'un autre client et confirmé, par écrit, que ça avait échoué ? Protéger les données d'un client de celles d'un autre, c'est le volet accès d'une discipline plus large — [Pourquoi mikbry.com n'a pas de bannière cookies](/blog/privacy/pas-de-banniere-cookies) couvre le volet collecte : ce qu'un site récolte sur ses visiteurs, et pourquoi en récolter moins est plus sûr.
### 4. Changer la base qui contient de vraies données
Pourriez-vous vraiment annuler ce changement ce soir, ou supposez-vous seulement que oui ? La plupart des équipes n'ont jamais testé la réponse — une sauvegarde jamais restaurée n'est pas une sauvegarde, c'est un espoir. Les changements de base de données sont dangereux parce que l'ancien état a souvent disparu au moment où on remarque un problème — l'app continue d'écrire par-dessus. Le [guide de migration de Google Cloud](https://docs.cloud.google.com/architecture/database-migration-concepts-principles-part-2) recommande de tester le changement d'abord, de sauvegarder la cible, et d'avoir un vrai plan pour tout remettre en place — pas seulement de croire qu'il existe. Si ça tourne mal, les données clients sont silencieusement corrompues, et la dernière sauvegarde jamais testée date de plusieurs heures.
### 5. Les clés qui mettent le code en production
Un ordinateur portable compromis, ou une clé API volée, pousse du nouveau code directement chez les clients. Personne de plus pour regarder, pas de délai, pas de retour arrière. C'est précisément le risque ici. Ça, c'est facile à rater. Et pourtant ça décide si les quatre points précédents veulent dire quoi que ce soit — si n'importe qui avec un ordinateur portable peut pousser directement en production, rien de tout ça ne compte. Les [GitHub environments](https://docs.github.com/en/actions/how-tos/deploy/configure-and-manage-deployments/review-deployments), par exemple, peuvent exiger l'approbation d'une deuxième personne avant qu'un déploiement ne s'exécute, et retenir les clés de production jusque-là. Des contrôles équivalents existent ailleurs ; la logique est la même. Une seule personne, ou un seul agent, pourrait-il pousser un changement en production tout seul, ce soir, sans que personne d'autre ne surveille ?
Une approbation ne suffit pas
Rien de tout ça ne se règle en collant un bouton d'approbation au bout d'un déploiement. Un relecteur pressé peut laisser passer une preuve faible aussi facilement qu'un agent peut la manquer. Une approbation de façade est pire que pas d'approbation du tout : elle met le nom de quelqu'un sur une décision que personne n'a vraiment prise.
L'approbation vaut quelque chose quand elle s'appuie sur un compte-rendu court et honnête, pas un rapport de cent pages que personne ne lit : ce qui change vraiment, quels cas ont été testés (y compris ceux censés échouer), qui pourrait être affecté si ça tourne mal, ce qui reste incertain, et comment tout annuler si ça part en vrille. C'est une page, pas un livre. Quelqu'un de nommé la lit, comprend ce qui reste incertain, et décide si le risque qui reste vaut la peine d'être pris.
Un Scan peut repérer des erreurs connues. C'est utile. Mais il ne peut pas décider si le risque qui reste est acceptable — c'est un jugement, pas un calcul. Le score est une preuve, pas une permission de lancer.
Avant d'appuyer sur le bouton, cinq questions à se poser honnêtement :
- Quelqu'un a-t-il testé ce qui se passe quand un paiement échoue à mi-chemin ?
- Un inconnu pourrait-il entrer dans le compte de quelqu'un d'autre avec seulement des informations publiques ?
- Quelqu'un a-t-il volontairement essayé d'ouvrir les données d'un autre client et confirmé que ça échouait ?
- Avez-vous vraiment testé une restauration de sauvegarde récemment, ou juste supposé que ça marcherait ?
- Une seule personne, ou un seul agent, pourrait-il pousser directement en production ?
Si l'une de ces réponses est « je ne sais pas », ce n'est pas une décision de mise en production. C'est un pari déguisé en décision.
Le lancement n'est que le début
Passer ces vérifications ne veut pas dire que le produit est terminé.
Ça veut simplement dire que vous avez évité de laisser vos premiers vrais utilisateurs découvrir à votre place certains risques que vous pouviez identifier avant.
Ensuite, la réalité commence.
Les utilisateurs vont faire des choses que vous n'aviez pas prévues. Un paiement va échouer dans un cas que personne n'avait testé. Une fonctionnalité secondaire va devenir importante. Une autre, peaufinée pendant une semaine, ne sera presque jamais utilisée. Les coûts vont bouger, les dépendances évoluer, le trafic arriver de façon irrégulière.
C'est normal.
Un produit qui fonctionne n'avance pas en ligne droite du prototype au lancement. C'est une boucle permanente : lancer, observer, apprendre, corriger, simplifier, puis relancer.
L'objectif avant la production n'est donc pas d'obtenir un produit parfait. C'est de comprendre les risques évidents, de maîtriser les plus dangereux et d'avoir assez de visibilité pour apprendre sans mettre le produit en danger.
Être prêt à lancer, c'est arriver en meilleur état sur la ligne de départ.
Après, le vrai travail produit commence.
Trust Report et Audit
Ces cinq sujets, c'est le volet sécurité et accès de la discipline. Pour le volet financier — ce qui fait vraiment grimper une facture après le lancement — [Combien coûte une app construite avec l'IA ?](/blog/ai/combien-coute-une-app-construite-avec-ia) couvre ça.
Trois niveaux : un Scan gratuit et automatisé, un Trust Report automatisé plus approfondi, puis un Audit qui combine mes outils avec une revue CTO humaine.
Avant de demander une revue CTO, vous pouvez commencer par le [Trust Scan](https://mikbry.com/launch-readiness/) — il tourne en local, votre code source reste sur votre machine, et seuls les extraits que vous approuvez explicitement sont transmis. Il donne une première lecture automatique, mais ne voit ni votre environnement de production ni le contexte métier.
### Trust Report — 349 €
Une revue automatisée de votre app et de son code, réalisée avec mes outils d'analyse. Vous obtenez les principaux risques, ce qui mérite l'attention avant le lancement et ce qui peut attendre. Si vous souhaitez parcourir les résultats ensemble, une revue avec moi est disponible en option.
### Audit — à partir de 1 200 €
Une revue plus approfondie couvrant l'architecture, les paiements, les accès, les données clients, les changements de base de production, la garde des clés de déploiement, et la préparation à la production — les mêmes cinq sujets, avec mes outils et une lecture humaine par un CTO, et une recommandation de mise en production documentée.
---
# https://mikbry.com/blog/ai/six-ai-built-app-red-flags/
# Six things I check before trusting an AI-built app in production
Mik Bry · 2026-07-22 · ~10 min read · AI · Security
Your app works. Pages load, sign-up works, the payment screen appears, and the demo looks convincing.
That is useful. It is not the same as being ready for production.
The questions change as soon as real users, real money and real data enter the picture. I stop asking only whether the normal path works. I start asking what happens when someone changes a number in a URL, a payment fails halfway through, a script creates hundreds of accounts, a private key becomes visible to visitors, or the interface says “success” while nothing actually happened behind it.
AI did not invent these problems. I made some of the same mistakes years before AI wrote code for me. What AI changes is the speed: you can now reach a convincing product much faster, including the parts nobody has really challenged yet.
These are six things I check early.
The six checks
1. [Payments work — but only on the expected path](#s1)
2. [The server trusts the browser](#s2)
3. [Nothing slows abuse down](#s3)
4. [Secrets leak into places they should not](#s4)
5. [The database may not protect one customer from another](#s5)
6. [Failure looks like success](#s6)
01 — Payments work — but only on the expected path
A checkout can look finished while the payment system is not.
The obvious checks are still worth doing: are you using the payment provider's test setup or the real one? Does the provider's confirmation come back to your app? Does your app record the final result correctly?
But I do not stop at the Stripe screen.
I also look for every other way the app can mark an account as paid, create or upgrade a subscription, unlock access, or change someone's billing status. A clean Stripe integration does not help if another hidden route in the app can produce the same result without the same checks.
A safe first check
Open your payment provider dashboard and confirm whether the environment is test or live. In test mode, use the provider's published test cards and verify that the application records both successful and failed payments correctly. If you are already live, plan a small refundable transaction rather than experimenting with a real customer charge.
Passing this check does not prove the payment system is safe. It tells you whether the most obvious path is wired correctly.
Reference:Stripe — Go-live checklist covers test/live configuration, production webhooks, duplicate or delayed events, API keys and edge cases.
02 — The server trusts the browser
Your interface knows which invoice, project or account you are looking at. That does not mean the server has checked whether you are allowed to see it.
The classic version is simple: you open `/invoice/42`, change `42` to `41`, and the application returns someone else's invoice.
Your app should never assume that something is trustworthy just because it came from the visitor's browser. Visitors can change what their browser sends.
A safe first check
Create two test accounts that you control. Log in as one of them and try to open something belonging to the other by changing the number or code in the URL. A safe application refuses. If it returns the other account's data, stop there. You have already found the problem.
Reference:OWASP — Insecure Direct Object Reference Prevention recommends this same type of check: use two accounts and verify that one cannot access objects belonging to the other by changing an object reference.
03 — Nothing slows abuse down
A form that works once can sometimes be called ten thousand times.
Sign-up is the obvious example, but the same problem applies to password reset, invitations, file uploads, sending emails, one-time login codes, and features connected to an AI provider.
The AI case deserves special attention. If your app sends requests to OpenAI, Anthropic, Mistral or another provider using your account, an attacker may be able to use your app as a relay and trigger paid requests at your expense. A badly protected AI feature can therefore turn abuse into a very real bill.
Without checks that slow repeated or suspicious use, a feature that looks harmless during a demo can become expensive very quickly.
A safe first check
Use only accounts and addresses you control and repeat the same action several times. Does anything slow you down, ask for confirmation or reject obvious repetition? If nothing ever pushes back, that is worth reviewing — especially on features that cost you money every time they are used.
Private access keys copied into files that were accidentally shared with the source code. Database passwords showing up in technical logs. A live payment key sent to every visitor's browser. These mistakes are still common because the app can appear to work perfectly while they remain invisible.
AI tools can connect services very quickly. That does not mean they always put the private keys in the right place.
A safe first check
Ask where the private keys used for payments, the database, email and AI services are stored, and whether any of them are sent to a visitor's browser or included in code that other people can see.
You can also look at what your browser receives for obvious leaks, or ask a technical person to do it. Finding nothing does **not** prove your secrets are safe; this only catches the easiest mistakes.
References:OWASP — Secrets Management explains why API keys and database credentials should not be hard-coded or scattered through configuration files. GitHub — Secret scanning documents the risk of exposed API keys, passwords and tokens in repositories.
05 — The database may not protect one customer from another
A polished interface can hide a serious problem: the screen only shows your own data, but the system behind it may still allow access to someone else's.
Services such as Supabase can enforce rules directly where the data is stored: for example, “this customer can only read their own records.” Other systems enforce the same rule elsewhere.
The technology is not the important part. What matters is that the protection exists somewhere the visitor cannot simply bypass.
A safe first check
Open the security section of your database or hosting service and look for warnings about customer-data access. If you use Supabase, its Security Advisor and row-level security checks are good places to start. Then test with two accounts you control: one account should never be able to read the other's data.
> **My tip:** tools such as Supabase are very convenient when you want to build quickly. They give you a database, login system, file storage and other services in one place.
>
> For a product that I expect to grow, I usually prefer to keep the database more independent from the rest of the stack. In practice, that means using a managed PostgreSQL service such as Neon or AWS and letting the application talk to it through its own server.
>
> Why? Because if the product succeeds, you may want to change how login works, move part of the application, add another service, or simply control database costs separately. Keeping the database independent gives you more freedom later.
>
> This does **not** mean Supabase is a bad choice or always more expensive. It is often an excellent way to build an MVP. My point is simply that convenience at the beginning can become dependence later, so I prefer to make that choice consciously.
References:Supabase — Row Level Security says RLS is enabled by default for tables created with the Dashboard Table Editor, while tables created with raw SQL or the SQL Editor need RLS to be enabled explicitly. Supabase also says RLS should be enabled on tables in exposed schemas. Its Production Checklist recommends reviewing Security Advisor findings and enabling RLS with appropriate policies before production.
06 — Failure looks like success
This one is easy to miss because the interface can look perfect.
The payment screen says success, but nothing was recorded. The contact form turns green, but the message was never sent. The upload finishes, but the file is missing. The screen has finished its animation while the real operation behind it failed.
In AI-built applications I review, failures are often tested much less than the normal, successful path.
A safe first check
Use harmless invalid inputs and situations designed to fail. Submit an empty upload. Enter a negative value where only positive values make sense. Try a payment test that is supposed to be rejected. The app should refuse clearly, without leaving half-finished data behind.
A green message is not evidence that the operation succeeded.
References:OWASP — Input Validation recommends validating both the format and the business meaning of incoming values. OWASP — Error Handling recommends explicitly handling failure cases rather than leaving the application in an unpredictable state.
## Before you launch
Ask six simple questions:
- **Payments:** has the real payment state been verified, including failure cases and adjacent paths that grant paid access?
- **Access:** can one test account open data belonging to another?
- **Abuse:** what stops an automated script from repeating an expensive or sensitive action — especially one that calls an AI service you pay for?
- **Secrets:** do you know where your production keys are stored and who or what can read them?
- **Data:** is there a rule, outside the visitor's control, that keeps one customer's data separate from another's?
- **Failures:** when an operation fails, does the product actually fail safely instead of only changing the UI?
If one answer is “I don't know,” you have found something to investigate. You have not necessarily found a catastrophe.
That distinction matters.
If you want to go further
I review AI-built and vibe-coded applications before they go into production.
Start here
Trust Report
An automated review of your app and its code, using my analysis tools. You get the main risks, what deserves attention before launch, and what can wait. If you want to discuss the findings, a review with me is available as an option.
The six checks above are a useful first pass. They can catch obvious problems, but they cannot show you what you do not yet know to test.
If the app is about to handle real users, real money or sensitive data, that is precisely where an experienced technical review becomes useful.
---
# https://mikbry.com/blog/ai/six-signaux-alerte-app-ia/
# Les 6 choses que je vérifie avant de mettre une app construite avec l'IA en production
Mik Bry · 2026-07-22 · lecture ~10 min · IA · Sécurité

Votre app tourne. Les pages s'affichent, l'inscription fonctionne, le paiement apparaît et la démo est convaincante.
C'est déjà beaucoup. Mais ce n'est pas la même chose qu'être prêt pour la production.
Dès qu'il y a de vrais utilisateurs, de l'argent et des données réelles, les questions changent. Je ne regarde plus seulement si le parcours prévu fonctionne. Je regarde ce qui se passe quand on change un numéro dans une URL, quand un paiement échoue à moitié, quand un script crée des centaines de comptes, quand une clé privée devient visible pour les visiteurs ou quand l'interface affiche « succès » alors qu'en réalité rien ne s'est passé derrière.
L'IA n'a pas inventé ces problèmes. J'ai fait certaines des mêmes erreurs bien avant qu'elle écrive du code pour moi. Ce qu'elle change, c'est la vitesse : on arrive beaucoup plus vite à un produit crédible, y compris dans des zones que personne n'a encore vraiment mises à l'épreuve.
Voici les six choses que je regarde en premier.
Les six vérifications
1. [Le paiement marche… sur le chemin prévu](#s1)
2. [Le serveur fait trop confiance au navigateur](#s2)
3. [Rien ne freine les abus](#s3)
4. [Des secrets se retrouvent là où ils ne devraient pas](#s4)
5. [La base de données ne protège pas forcément un client d'un autre](#s5)
6. [Un échec ressemble à un succès](#s6)
01 — Le paiement marche… sur le chemin prévu
Un écran de paiement peut donner l'impression que tout est terminé alors que le système ne l'est pas.
Les vérifications évidentes restent indispensables : êtes-vous en mode test ou en production ? La confirmation du prestataire de paiement revient-elle bien vers votre app ? L'application enregistre-t-elle correctement le résultat final ?
Mais je ne m'arrête pas à l'écran Stripe.
Je cherche aussi toutes les autres façons dont l'app peut considérer un compte comme payé, créer ou modifier un abonnement, ouvrir un accès ou changer son statut de facturation. Une intégration Stripe propre ne sert pas à grand-chose si un autre chemin caché dans l'app peut produire le même résultat sans les mêmes contrôles.
Premier test · sans risque
Ouvrez le tableau de bord de votre prestataire de paiement et vérifiez l'environnement utilisé. En mode test, utilisez ses cartes de test et vérifiez que l'application traite correctement les paiements réussis **et** les échecs. Si vous êtes déjà en production, planifiez un petit paiement remboursable plutôt que d'improviser avec une vraie transaction client.
Passer ce test ne prouve pas que le système de paiement est sûr. Il confirme simplement que le chemin le plus évident est correctement branché.
Référence :Stripe — checklist de mise en production couvre notamment le passage test/production, les webhooks de production, les événements retardés ou dupliqués, les clés API et les cas limites.
02 — Le serveur fait trop confiance au navigateur
L'interface sait quelle facture, quel projet ou quel compte vous regardez. Ça ne veut pas dire que le serveur a vérifié que vous aviez le droit d'y accéder.
Le cas classique est simple : vous ouvrez `/facture/42`, vous remplacez `42` par `41`, et l'application vous renvoie la facture de quelqu'un d'autre.
L'app ne doit jamais considérer qu'une information est fiable simplement parce qu'elle vient du navigateur du visiteur. Ce que le navigateur envoie peut être modifié.
Premier test · sans risque
Créez deux comptes de test que vous contrôlez. Connectez-vous avec le premier et essayez d'ouvrir une donnée appartenant au second en changeant le numéro ou le code visible dans l'URL. Une application correctement protégée refuse. Si elle renvoie les données de l'autre compte, arrêtez-vous là : vous avez déjà trouvé le problème.
Référence :OWASP — Insecure Direct Object Reference Prevention (en anglais) recommande précisément ce type de test : utiliser deux comptes et vérifier que l'un ne peut pas accéder aux objets de l'autre en modifiant une référence.
03 — Rien ne freine les abus
Un formulaire qui fonctionne une fois peut parfois être appelé dix mille fois.
L'inscription est le cas évident, mais le même problème existe pour la récupération de mot de passe, les invitations, l'envoi de fichiers, les e-mails, les codes de connexion à usage unique et les fonctions reliées à un fournisseur d'IA.
Ce dernier cas mérite une attention particulière. Si votre app envoie des requêtes à OpenAI, Anthropic, Mistral ou un autre service en utilisant votre compte, un attaquant peut parfois se servir de votre app comme relais et déclencher des requêtes payantes à vos frais. Une fonction IA mal protégée peut donc transformer un abus en vraie facture.
Sans protection qui ralentit ou bloque les usages répétitifs et suspects, une fonctionnalité anodine en démo peut devenir très coûteuse.
Premier test · sans risque
Utilisez uniquement des comptes et adresses que vous contrôlez et répétez plusieurs fois la même action. Est-ce qu'une limite apparaît ? Une confirmation ? Un délai ? Un refus face à une répétition évidente ? Si rien ne freine jamais, ça mérite une vraie revue — surtout pour une fonction qui vous coûte de l'argent à chaque utilisation.
Référence :OWASP API Security — Unrestricted Resource Consumption recommande de limiter la fréquence des appels et de configurer des limites de dépense chez les fournisseurs, car des appels répétés peuvent consommer des ressources payantes et avoir un impact business.
04 — Des secrets se retrouvent là où ils ne devraient pas
Une clé privée copiée par erreur dans des fichiers partagés avec le code. Un mot de passe de base de données qui apparaît dans des journaux techniques. Une clé de paiement de production envoyée au navigateur de chaque visiteur.
Ce sont des erreurs simples à créer et presque invisibles tant que l'app fonctionne.
Les outils d'IA peuvent connecter des services très vite. Ça ne garantit pas qu'ils rangent toujours les clés privées au bon endroit.
Premier test · sans risque
Demandez où sont stockées les clés utilisées pour les paiements, la base de données, l'e-mail ou les services d'IA, et si certaines sont envoyées au navigateur d'un visiteur ou incluses dans des fichiers accessibles à d'autres personnes.
Vous pouvez aussi regarder ce que reçoit votre navigateur, ou demander à quelqu'un de technique de le faire. Ne rien trouver ne prouve pas que tout est sûr : ce test sert seulement à repérer les erreurs les plus évidentes.
Références :OWASP — Secrets Management (en anglais) explique pourquoi les clés API et identifiants de base de données ne doivent pas être écrits en clair dans le code ou dispersés dans des fichiers de configuration. GitHub — Analyse de secrets documente les risques liés aux clés, mots de passe et jetons exposés dans un dépôt.
05 — La base de données ne protège pas forcément un client d'un autre
Une interface propre peut cacher un problème sérieux : l'écran ne montre que vos données, mais le système derrière peut malgré tout laisser passer celles de quelqu'un d'autre.
Des services comme Supabase permettent d'imposer directement une règle du type : « ce client ne peut lire que ses propres données ». D'autres systèmes appliquent la même protection ailleurs.
La technologie utilisée n'est pas le plus important. Ce qui compte, c'est que cette protection existe à un endroit que le visiteur ne peut pas contourner.
Premier test · sans risque
Ouvrez la partie sécurité de votre base de données ou de votre hébergeur et regardez s'il signale des problèmes d'accès aux données clients. Si vous utilisez Supabase, son Security Advisor et les règles de sécurité au niveau des lignes sont de bons points de départ. Ensuite, faites un test avec deux comptes que vous contrôlez : l'un ne doit jamais pouvoir lire les données de l'autre.
> **Mon conseil :** des outils comme Supabase sont très pratiques pour construire vite. Ils regroupent la base de données, la connexion des utilisateurs, le stockage de fichiers et d'autres services au même endroit.
>
> Pour un produit qui a vocation à durer et à grossir, je préfère généralement garder la base de données plus indépendante du reste. Concrètement, cela peut vouloir dire utiliser un service PostgreSQL managé comme Neon ou AWS, et laisser l'application y accéder via son propre serveur.
>
> Pourquoi ? Parce que si le produit fonctionne, vous voudrez peut-être changer la gestion des comptes, déplacer une partie de l'application, ajouter d'autres services ou simplement mieux maîtriser le coût de la base. Garder cette brique indépendante donne plus de liberté pour la suite.
>
> Cela ne veut **pas** dire que Supabase est un mauvais choix ou qu'il sera toujours plus cher. C'est souvent un excellent outil pour construire un MVP. Mon point est simplement que la simplicité du départ peut devenir une dépendance plus tard, donc je préfère faire ce choix en connaissance de cause.
Références :Supabase — Row Level Security (en anglais) indique que la RLS est activée par défaut pour les tables créées avec le Table Editor du Dashboard, mais qu'elle doit être activée explicitement pour les tables créées en SQL ou via le SQL Editor. Supabase recommande aussi d'activer la RLS sur les tables des schémas exposés. Sa checklist de production (en anglais) recommande de vérifier le Security Advisor et les politiques RLS avant la mise en production.
06 — Un échec ressemble à un succès
C'est un problème facile à rater parce que l'interface peut être parfaite.
Le paiement affiche « succès », mais rien n'a été enregistré. Le formulaire devient vert, mais le message n'est jamais parti. L'upload se termine, mais le fichier n'existe pas. L'animation est finie, alors que l'opération réelle derrière a échoué.
Dans les apps construites avec l'IA que je relis, les échecs sont souvent beaucoup moins testés que le parcours normal qui fonctionne.
Premier test · sans risque
Utilisez des valeurs invalides mais sans conséquence et des situations prévues pour échouer. Envoyez un fichier vide. Saisissez une valeur négative là où elle n'a aucun sens. Faites un paiement de test prévu pour être refusé. L'app doit refuser clairement, sans laisser derrière elle des données à moitié enregistrées.
Un message vert n'est pas une preuve que l'opération a réussi.
Références :OWASP — Input Validation (en anglais) recommande de vérifier à la fois la forme des données et leur cohérence métier. OWASP — Error Handling (en anglais) recommande de traiter explicitement les cas d'échec afin de ne pas laisser l'application dans un état imprévisible.
## Avant de mettre en production
Posez-vous six questions simples :
- **Paiements :** l'état réel du paiement a-t-il été vérifié, y compris les échecs et les chemins adjacents qui peuvent ouvrir un accès payant ?
- **Accès :** un compte de test peut-il ouvrir les données d'un autre ?
- **Abus :** qu'est-ce qui empêche un script de répéter une opération sensible ou coûteuse — notamment une fonction qui appelle un service d'IA que vous payez ?
- **Secrets :** savez-vous où sont stockées vos clés de production et qui peut les lire ?
- **Données :** existe-t-il une règle, hors du contrôle du visiteur, qui sépare réellement les données de chaque client ?
- **Échecs :** quand une opération échoue, le produit échoue-t-il vraiment proprement au lieu de seulement changer l'interface ?
Si une réponse est « je ne sais pas », vous avez trouvé quelque chose à vérifier. Pas forcément une catastrophe.
La nuance est importante.
Si vous voulez aller plus loin
Je relis des applications construites avec l'IA ou en vibe coding avant leur mise en production.
Commencer ici
Trust Report
Une revue automatisée de votre app et de son code, réalisée avec mes outils d'analyse. Vous obtenez les principaux risques, ce qui mérite l'attention avant le lancement et ce qui peut attendre. Si vous souhaitez parcourir les résultats ensemble, une revue avec moi est disponible en option.
Architecture, paiements, accès, données clients, garde des clés de déploiement, logiciels tiers, et une recommandation de mise en production documentée par un CTO humain.
Les six vérifications ci-dessus constituent un bon premier filtre. Elles peuvent faire ressortir des problèmes évidents, mais elles ne peuvent pas vous montrer ce que vous ne savez pas encore qu'il faut tester.
Si l'app s'apprête à gérer de vrais utilisateurs, de l'argent ou des données sensibles, c'est précisément là qu'un regard technique expérimenté devient utile.
---
# https://mikbry.com/blog/ai/cost-of-launching-an-ai-built-app/
# What does it cost to launch an AI-built app?
Mik Bry · 2026-07-23 · ~8 min read · AI
The pitch you keep seeing is: pay twenty dollars a month for the AI, describe what you want, ship an app. Tool, outcome, nothing in between.
Everything is in between. Twenty dollars a month buys you a hammer, not a house. Between the hammer and the house sit a foundation, plumbing, wiring, a roof, a door, an address — and someone showing up every month with a bill.
I'm not reviewing code in this piece. This is for the stage before that: what it actually costs to get an AI-built app in front of real users, so you can plan for it instead of discovering it.
The real question isn't "how much does an AI-built app cost?" It's "what makes the bill grow when usage starts?" A number goes stale the day a provider changes a tier; the mechanism that turns it loud doesn't.
Freshness note
Every price below was checked against the provider's own page on **17–18 August 2026**, with a source link. Providers change tiers without warning; treat anything older than a few months as a starting point, not a quote. I re-check this list roughly every quarter.
Where the money goes
1. [Fixed costs before your first user](#s1)
2. [Usage-based costs that jump](#s2)
3. [Mobile and AI costs, if they apply to you](#s3)
4. [Five questions to answer before you budget](#s4)
5. [My default: EU providers, a VPS, and boring economics](#s5)
6. [Launch readiness](#s6)
01 — Fixed costs before your first user
Any app a real person can use — pay for, log into, get emails from — sits on a small pile of services: a domain, hosting, a database, email delivery, authentication, file storage, a build pipeline, a payment provider, analytics, error tracking, and, if your product does AI work, an LLM API on the back end.
Most of that pile is free or near-free before anyone shows up. What's genuinely fixed, regardless of traffic, is smaller than it looks: a domain (roughly €10–20/year), a baseline hosting plan, and — only if you're building mobile — the [Apple Developer Program at $99/year](https://developer.apple.com/programs/) and a [one-time $25 Google Play Console registration](https://support.google.com/googleplay/android-developer/answer/6112435).
Everything else starts free and turns usage-based the moment someone actually uses your app. That's the part worth planning for: the cost can stay close to zero for a while, then jump as soon as you cross a usage threshold.
Costs on this stack don't grow in a straight line. You use something for months at zero, cross a boundary you didn't know existed, and get a bill. Sometimes the free tier just ends.
Two confirmed, dated examples. **SendGrid retired its permanent free plan in late May 2025** — existing free accounts got a 60-day grace period, then paid-or-migrate; its cheapest paid plan starts around $19.95/month ([Twilio SendGrid changelog](https://www.twilio.com/en-us/changelog/sendgrid-free-plan)). **PlanetScale retired its free Hobby tier on 8 April 2024**; its cheapest entry plan is still $39/month ([PlanetScale changelog](https://planetscale.com/changelog/deprecating-hobby), [PlanetScale pricing](https://planetscale.com/pricing)). Neither was announced far in advance. **My rule: treat a free tier as a temporary offer, not as your business model.**
Supabase is a common choice for AI-built apps — it bundles Postgres, auth, file storage, and a native [pgvector extension for embeddings](https://supabase.com/docs/guides/ai) in one place, a good way to get something working fast. My reservation isn't quality, it's coupling: for a product I expect to grow, I usually prefer an independent managed Postgres — Neon, Scaleway, AWS RDS — so auth, storage, and the database can each change on their own schedule later. Know the caps either way: free holds 500MB and 50,000 monthly active users; the flat **Pro plan starts at $25/month and includes 100,000 MAU**, with usage charges past either quota ([Supabase pricing](https://supabase.com/pricing)) — the same shape of surprise as anything else usage-based here.
The sharper version of the same problem is a database that bills per operation from the start. Firestore's rate isn't one number — it varies by region and edition, Standard and Enterprise using different pricing models entirely ([Firebase pricing](https://firebase.google.com/docs/firestore/pricing)). One dated illustration, not a universal quote: Google's own billing example puts a single-region Standard rate at **$0.06 per 100,000 document reads and $0.18 per 100,000 writes**, after a free daily quota of 50,000 reads, as of 18 August 2026 ([billing example](https://firebase.google.com/docs/firestore/billing-example)). What doesn't vary is the mechanism — it stops being cheap per unit the moment one screen mounts a live listener and every visitor, on every visit, re-triggers it. Know what one visitor doing one ordinary thing costs, before thousands do many.
A detail worth knowing before you rely on it
Google Cloud's own documentation is explicit: an "alerts-only" budget **does not** cap spending or stop your services — it emails you after the threshold is crossed, and the meter keeps running unless you build a separate mechanism to disable billing yourself.
If you're already on Firestore, that's not a verdict — plenty of small apps run there for a long time inside the free quota. It's a reason to know the mechanism before you're the one explaining the bill. One widely discussed Hacker News case described a misconfigured process turning a roughly $50/month bill into tens of thousands in a single day after an unexpected volume of writes — unusual, but a useful illustration that budget alerts alone don't prevent it ([Hacker News thread](https://news.ycombinator.com/item?id=42732714)).
Moving off Firestore later isn't free either: Google's export tooling writes to a Firestore-specific format, usable inside Firestore or BigQuery, with no documented direct path to another database — migrating means building that conversion yourself ([Firebase export/import docs](https://firebase.google.com/docs/firestore/manage-data/export-import)).
Two categories only matter if your product touches them — but when it does, they move the numbers more than anything above.
**Mobile.** Apple's standard commission is 30%, or 15% on subscriptions after a customer's first paid year. The Small Business Program drops that to 15% overall for developers under $1M in annual proceeds — cross that line mid-year and you're back to 30% for the rest of it ([Apple Small Business Program](https://developer.apple.com/app-store/small-business-program/)). Google Play's fees depend on the programme and billing model, not one flat number: a common tier is 15% on your first $1M/year and 30% above, subscriptions commonly at 15% regardless of revenue ([Google Play service fees](https://support.google.com/googleplay/android-developer/answer/112622)) — but alternative-billing programmes can lower that, and a **restructured fee took effect 30 June 2026 in the US, UK, and EEA**, splitting the old rate into a service fee plus a billing fee ([Android Developers blog](https://android-developers.googleblog.com/2026/06/play-expanded-billing.html)). Check your programme terms rather than assuming the simple version is universal. Building mobile CI on GitHub Actions? For private repos, a macOS runner costs roughly 10x a Linux one, free tier 2,000 minutes a month — public repos on standard runners are free, but an iOS build weekend on a private one can burn through that fast ([GitHub Actions billing](https://docs.github.com/en/billing/concepts/product-billing/github-actions)).
**AI.** The $20/month you pay for ChatGPT or Claude is a consumer subscription — you're the user. A product calling the same AI for *your* users pays the API price instead, per token, sent and received. As of 18 August 2026, Claude Sonnet 5 is $2 per million input tokens and $10 per million output tokens. That introductory price runs through 31 August; Anthropic lists $3/$15 from 1 September ([Anthropic pricing](https://platform.claude.com/docs/en/about-claude/pricing)). OpenAI's GPT-5.6 Sol is $5 in, $30 out ([OpenAI API pricing](https://developers.openai.com/api/docs/pricing)). Both will change again — check the date, not just the number.
Here's the shape of the surprise. A chatbot has no memory of its own, so it resends the growing conversation on every turn — a "10,000-token conversation" is really many small messages, each carrying the whole history back, and output tokens cost more than input. Put those together and a feature that looks like a few dollars a day can become real money at the volume a genuinely-used app produces — potentially the largest line on the bill. Anthropic's prompt caching discounts repeated context up to 90% on a cache hit, and its batch API is 50% off for non-real-time work. Provider changes usually mean adjusting prompts, not a rewrite from zero, but it's real work, worth planning for rather than discovering.
Before spending anything on construction, these are worth answering in a page, not a spreadsheet:
1. **Which of these categories apply to me** — mobile, AI-facing, cross-border EU sales — and which don't? Half this article may not apply to your idea.
2. **Where's my free-tier cliff**, on each service I rely on, and what happens the day I cross it?
3. **Do I know what normal usage from one user actually costs** — database, AI, storage, email — and how that cost changes as the number of users grows?
4. **Have I set a real spending cap**, or only a budget alert that emails me after the money's gone?
5. **What's the one choice** — usually the database, sometimes the AI provider — that decides whether month twelve is manageable?
If your idea's real, the table below maps where spending starts at each stage, not a forecast. No euro figures — the real number depends on your stack and usage pattern; the categories are the reusable part.
| Stage | What usually starts costing money |
|---|---|
| Pre-launch | Domain, hosting, paid tooling |
| Early users | Email delivery, database, logs, storage |
| Paying users | Auth crossing its free cap, payment fees, support tooling, AI usage |
| Growth | Database operations, egress, LLM inference, monitoring |
Infrastructure cost is rarely the only reason a product fails. But it gets painful fast when usage grows faster than revenue and nobody modelled the cost per user beforehand — the gap your own numbers above will show you, if you fill them in before you build rather than after.
The remedy isn't becoming an infrastructure expert. It's knowing your own stack's cost curve — which items on the list above you actually need, where each one's step-function boundary sits, and which single choice decides whether growth is manageable — before you commit to a stack that shapes everything else.
05 — My default: EU providers, a VPS, and boring economics
When I set up infrastructure for something I expect to run for years, my defaults aren't chosen for the lowest price line.
For hosting and storage, I default to French or European providers — Scaleway, OVH, sometimes Hetzner. It gives me a simpler data-location story, reduces my dependency on US hyperscalers, and keeps more of the technical chain in Europe.
For a small-team product with steady usage, I also default to a VPS over serverless: a fixed-size machine, a monthly bill known in advance, no cold starts. Serverless is the right tool for bursty, unpredictable traffic — I move a workload there when it actually needs it, not before.
None of this is dogma. Global edge inference or genuinely unpredictable burst capacity is a real reason to reach for a hyperscaler or serverless from day one. For most first products, the boring default is the safer one.
06 — Launch readiness
Back to the real question from the top: what makes the bill grow when usage starts. Money is one shape of the same underlying question — what haven't you checked yet? A hidden cost you didn't budget for and a security hole you didn't test for come from the same blind spot — something that only appears once real users, real payments, or real traffic arrive.
I check both, same discipline wearing different clothes. Knowing which costs are fixed, which are usage-based, and which is billed per operation instead of on a flat plan is worth naming *before* you launch — the same posture as checking who can read someone else's data, or what happens when a payment silently fails.
If you want the security and data side, [Six things I check before trusting an AI-built app in production](/blog/ai/six-ai-built-app-red-flags) covers it. This piece covers the financial-surprise side.
If you want to go further
I review AI-built and vibe-coded applications before they go into production.
Start here
Trust Report
An automated review of your app and its code, using my analysis tools. You get the main risks, what deserves attention before launch, and what can wait. If you want to discuss the findings, a review with me is available as an option.
---
# https://mikbry.com/blog/ai/combien-coute-une-app-construite-avec-ia/
# Combien coûte le lancement d'une app construite avec l'IA ?
Mik Bry · 2026-07-23 · lecture ~9 min · IA

Le discours qu'on entend partout : vingt euros par mois, vous décrivez votre idée à l'IA, l'app sort de terre. L'outil d'un côté, le résultat de l'autre — rien entre les deux, à en croire la pub.
Sauf que tout se joue justement entre les deux. Vingt euros par mois, ça achète un marteau, pas une maison. Entre le marteau et la maison, il y a les fondations, la plomberie, l'électricité, un toit, une porte, une adresse — et quelqu'un qui repasse chaque mois avec la facture.
Je ne fais pas de revue de code ici. Je parle de l'étape d'avant : ce que coûte, en vrai, le fait de mettre une app construite avec l'IA devant de vrais utilisateurs — pour l'anticiper plutôt que le découvrir en cours de route.
La vraie question n'est pas « combien coûte une app construite avec l'IA ? », mais « qu'est-ce qui fera monter la facture quand les utilisateurs arriveront ? » Un chiffre devient faux le jour où un fournisseur change de palier ; le mécanisme qui fait grimper la facture, lui, ne change pas.
Note de fraîcheur
Chaque prix ci-dessous a été vérifié sur la page du fournisseur le **17 août 2026** (18 août pour Supabase), avec un lien source. Les fournisseurs changent leurs forfaits sans prévenir : passé quelques mois, ces chiffres sont un point de départ, pas un devis. Je repasse sur cette liste à peu près tous les trimestres.
Où va l'argent
1. [Coûts fixes avant votre premier utilisateur](#s1)
2. [Coûts d'usage : le palier qui surprend](#s2)
3. [Coûts mobile et IA, si vous êtes concerné](#s3)
4. [Cinq questions à se poser avant de budgéter](#s4)
5. [Mes choix par défaut : fournisseurs européens, un VPS, des coûts prévisibles](#s5)
6. [Être prêt à lancer](#s6)
01 — Coûts fixes avant votre premier utilisateur
Une app qu'une vraie personne utilise — payer, se connecter, recevoir des e-mails — repose sur une petite pile de services : un nom de domaine, un hébergement, une base de données, l'envoi d'e-mails, l'authentification, du stockage de fichiers, un pipeline de build, un prestataire de paiement, de l'analytique, du suivi d'erreurs — et, si votre produit fait tourner de l'IA côté utilisateur, une API de LLM en back-end.
L'essentiel de cette pile ne coûte rien, ou presque, tant que personne n'arrive. Ce qui est vraiment fixe, quel que soit le trafic, tient en peu : un nom de domaine (10-20 €/an), un forfait d'hébergement de base, et — seulement pour le mobile — le [Programme Développeur Apple à 99 $/an](https://developer.apple.com/programs/) et les [25 $ d'inscription Google Play Console](https://support.google.com/googleplay/android-developer/answer/6112435).
Le reste démarre gratuit et bascule en coût d'usage dès que quelqu'un se sert vraiment de votre app. C'est cette bascule qu'il faut anticiper : elle n'arrive pas comme une ligne mensuelle, elle arrive d'un coup, une fois le seuil franchi.
Les coûts sur cette pile ne montent pas en ligne droite. On utilise un service pendant des mois sans rien payer, on franchit un seuil inconnu, et la facture tombe. Parfois, c'est le forfait gratuit lui-même qui disparaît.
Deux exemples confirmés et datés. **SendGrid a supprimé son forfait gratuit permanent fin mai 2025** — 60 jours de sursis pour les comptes existants, puis payer ou migrer ; son forfait payant le moins cher démarre autour de 19,95 $/mois ([changelog Twilio SendGrid](https://www.twilio.com/en-us/changelog/sendgrid-free-plan)). **PlanetScale a retiré son forfait gratuit Hobby le 8 avril 2024** ; son offre d'entrée reste à 39 $/mois aujourd'hui ([changelog PlanetScale](https://planetscale.com/changelog/deprecating-hobby), [tarifs PlanetScale](https://planetscale.com/pricing)). Aucune des deux annonces n'a été faite très à l'avance. Ma règle : **un forfait gratuit est une offre temporaire, pas un modèle économique.**
Supabase est devenu un choix fréquent pour les apps construites rapidement avec l'IA — Postgres, auth, stockage et un [pgvector natif pour les embeddings](https://supabase.com/docs/guides/ai) réunis au même endroit, une bonne façon de faire marcher quelque chose vite. Ma réserve n'est pas la qualité, c'est le couplage : pour un produit que je vise à faire grossir, je préfère une base Postgres indépendante — Neon, Scaleway, AWS RDS — pour faire évoluer auth, stockage et base séparément plus tard. Connaissez les plafonds : le gratuit tient à 500 Mo et 50 000 utilisateurs actifs par mois ; le Pro, à prix fixe, démarre à **25 $/mois et inclut 100 000 utilisateurs actifs**, facturation à l'usage au-delà ([tarifs Supabase](https://supabase.com/pricing)) — même mécanique que tout service à l'usage sur cette liste.
La version la plus aiguë du même problème, c'est une base facturée à l'opération dès le départ. Le tarif de Firestore n'est pas un chiffre unique — il varie selon la région et l'édition, Standard et Enterprise utilisant des modèles différents ([tarifs Firebase](https://firebase.google.com/docs/firestore/pricing)). Une illustration datée, pas une vérité universelle : l'exemple de facturation de Google donne un tarif Standard mono-région à **0,06 $ pour 100 000 lectures et 0,18 $ pour 100 000 écritures**, après un quota gratuit quotidien de 50 000 lectures, au 18 août 2026 ([exemple de facturation](https://firebase.google.com/docs/firestore/billing-example)). Ce qui ne varie pas, c'est le mécanisme : ça cesse d'être bon marché dès qu'un écran monte un écouteur en temps réel et que chaque visiteur, à chaque visite, le redéclenche. Sachez ce que coûte un visiteur ordinaire avant d'en avoir des milliers.
Un détail à connaître avant de s'y fier
La documentation de Google Cloud est explicite : un budget « alertes seules » **ne plafonne pas** la dépense et n'arrête aucun service — il envoie un e-mail une fois le seuil franchi, et le compteur continue de tourner tant que vous n'avez pas construit vous-même un mécanisme séparé pour couper la facturation.
Si vous êtes déjà sur Firestore, ce n'est pas un verdict — beaucoup de petites apps y tournent longtemps dans le quota gratuit. Autant connaître le mécanisme avant d'avoir à l'expliquer sur la facture. Un cas largement commenté sur Hacker News décrit un processus mal configuré qui a fait passer une facture d'environ 50 $/mois à des dizaines de milliers de dollars en une seule journée, après une écriture massive et imprévue dans le stockage — un échec vraiment inhabituel, pas un résultat typique, mais une bonne illustration du fait qu'une alerte seule ne suffit pas à l'empêcher ([fil Hacker News](https://news.ycombinator.com/item?id=42732714)).
Sortir de Firestore plus tard n'est pas gratuit non plus : l'export de Google écrit dans un format propre à Firestore, réutilisable dans Firestore ou BigQuery, sans chemin direct vers une autre base — migrer veut dire construire cette conversion soi-même ([documentation export/import Firebase](https://firebase.google.com/docs/firestore/manage-data/export-import)).
**Un mot sur la TVA transfrontalière.** Si vous vendez des services numériques à des particuliers dans l'UE, les règles de TVA changent une fois votre activité transfrontalière au-delà du seuil de l'UE — **10 000 €/an** combinés aujourd'hui ([Commission européenne — OSS](https://vat-one-stop-shop.ec.europa.eu/one-stop-shop_en)). Le guichet unique **OSS** simplifie la déclaration, il ne supprime pas l'obligation. Vérifiez votre situation exacte avec votre comptable avant de facturer à l'étranger.
Deux catégories qui ne comptent que si votre produit les touche vraiment — mais elles bougent alors les chiffres plus que tout le reste.
**Mobile.** La commission standard d'Apple est de 30 %, ou 15 % sur les abonnements après la première année payante d'un client. Le Small Business Program ramène ce taux à 15 % pour les développeurs sous 1 M$ de revenus annuels — dépassez ce seuil en cours d'année et vous repassez à 30 % jusqu'à la fin de l'exercice ([Apple Small Business Program](https://developer.apple.com/app-store/small-business-program/)). Les frais de Google Play dépendent du programme et du mode de facturation, pas d'un taux unique : un palier courant est 15 % sur le premier million de dollars annuels et 30 % au-delà, les abonnements souvent à 15 % quel que soit le revenu ([frais de service Google Play](https://support.google.com/googleplay/android-developer/answer/112622)) — mais des programmes alternatifs peuvent réduire ce taux, et une restructuration a pris effet le **30 juin 2026 aux États-Unis, au Royaume-Uni et dans l'EEE**, scindant l'ancien taux en frais de service réduit plus frais de facturation séparé ([blog Android Developers](https://android-developers.googleblog.com/2026/06/play-expanded-billing.html)). Vérifiez les conditions de votre programme plutôt que de supposer la version simple universelle. Sur GitHub Actions, pour un dépôt privé : un runner macOS coûte environ 10 fois un runner Linux, forfait gratuit de 2 000 minutes/mois — les dépôts publics sur runners standards sont gratuits, mais un week-end de build iOS sur un dépôt privé peut l'épuiser ([facturation GitHub Actions](https://docs.github.com/en/billing/concepts/product-billing/github-actions)).
**IA.** Les 20 $/mois payés pour ChatGPT ou Claude, c'est un abonnement grand public — vous êtes l'utilisateur. Un produit qui appelle la même IA pour vos utilisateurs paie le prix API à la place, au token, entrée comme sortie. Au 18 août 2026, Claude Sonnet 5 coûte 2 $/million de tokens en entrée et 10 $ en sortie. Ce tarif de lancement reste valable jusqu'au 31 août ; Anthropic annonce 3 $/15 $ à partir du 1er septembre ([tarifs Anthropic](https://platform.claude.com/docs/en/about-claude/pricing)). GPT-5.6 Sol d'OpenAI est à 5 $ en entrée, 30 $ en sortie ([tarifs API OpenAI](https://developers.openai.com/api/docs/pricing)). Les deux rebougeront — vérifiez la date de cette page, pas seulement le chiffre.
Voici la mécanique de la surprise. Un chatbot n'a pas de mémoire propre : il renvoie toute la conversation à chaque tour — une « conversation de 10 000 tokens », ce sont en réalité plusieurs messages, chacun traînant tout l'historique — et les tokens de sortie coûtent plus cher que ceux d'entrée. Additionnez, et une fonctionnalité qui ressemble à quelques dollars par jour peut peser lourd aux volumes qu'une petite app réellement utilisée produit — potentiellement la plus grosse ligne. Le prompt caching d'Anthropic réduit jusqu'à 90 % le coût d'un contexte répété en cas de cache hit, et son API batch coûte 50 % de moins hors temps réel. Changer de fournisseur demande d'ajuster les prompts plutôt que tout réécrire, mais ça reste du vrai travail, donc ça se planifie plutôt que ça se découvre.
Avant de dépenser quoi que ce soit en construction, voici ce qui mérite une réponse tenant sur une page, pas sur un tableur :
1. **Lesquelles de ces catégories me concernent vraiment** — mobile, IA côté utilisateur, ventes transfrontalières en UE — et lesquelles non ? La moitié de cet article peut très bien ne pas s'appliquer à votre idée.
2. **Où se situe mon palier de forfait gratuit**, sur chaque service que j'utilise, et que se passe-t-il vraiment le jour où je le dépasse ?
3. **Est-ce que je sais combien coûte l'usage normal d'un utilisateur** — base de données, IA, stockage, e-mails — et comment ce coût évolue quand le nombre d'utilisateurs augmente ?
4. **Ai-je posé un vrai plafond de dépense** quelque part, ou seulement une alerte qui m'e-maile une fois l'argent déjà parti ?
5. **Quel est le choix unique** — souvent la base de données, parfois le fournisseur d'IA — qui décide, au bout d'un an, si ça tient ou pas ?
Si votre idée est réelle, le tableau ci-dessous situe où la dépense démarre à chaque étape, pas une prévision. Pas de chiffres en euros — ça dépend de votre pile et de votre usage ; les catégories sont la partie réutilisable.
| Étape | Ce qui commence à coûter |
|---|---|
| Avant lancement | Domaine, hébergement, outils payants |
| Premiers utilisateurs | E-mails, base de données, logs, stockage |
| Utilisateurs payants | Auth, frais de paiement, support, usage IA |
| Croissance | Opérations en base, sortie de données, inférence LLM, monitoring |
L'infrastructure est rarement la seule raison pour laquelle un produit échoue. Mais ça devient douloureux vite quand l'usage grossit plus vite que le chiffre d'affaires et que personne n'a modélisé le coût par utilisateur — l'écart que vos propres chiffres montreront, si vous les remplissez avant de construire plutôt qu'après.
Le remède n'est pas de devenir expert en infrastructure. C'est de connaître la courbe de coût de sa pile — ce qu'on utilise vraiment, où se situe le palier de chacun, et quel choix unique décide si la croissance reste gérable — avant de s'engager sur une pile qui va tout structurer derrière.
Côté aides françaises : la **Bourse French Tech (Bpifrance)** est une subvention plafonnée à **30 000 €**, sous condition, qui couvre jusqu'à 50–70 % de dépenses éligibles selon la catégorie d'entreprise ; **Bpifrance i-Lab** est plafonné à **600 000 €** pour les entreprises de technologies innovantes, par éditions annuelles dont les dates de dépôt changent ([Bourse French Tech](https://www.bpifrance.fr/catalogue-offres/bourse-french-tech), [i-Lab](https://www.bpifrance.fr/nos-appels-a-projets-concours/concours-dinnovation-i-lab)). La règle qui piège le plus de monde : les dépenses engagées avant la date de dépôt du dossier ne sont pas éligibles — le dossier se dépose avant de dépenser sur les activités couvertes, pas après.
05 — Mes choix par défaut : fournisseurs européens, un VPS, des coûts prévisibles
Quand je pose l'infrastructure d'un projet que je compte faire durer, mes choix ne sont pas d'abord dictés par le prix le plus bas.
Pour l'hébergement et le stockage, je pars par défaut sur des fournisseurs français ou européens — Scaleway, OVH, parfois Hetzner. Ça simplifie la question de la localisation et des transferts de données, réduit ma dépendance aux grands clouds américains et garde une plus grande partie de la chaîne technique en Europe.
Pour un produit à petite équipe avec un usage stable, je pars aussi sur un VPS plutôt que du serverless : machine de taille fixe, facture mensuelle connue à l'avance, pas de cold start. Le serverless est le bon outil pour un trafic imprévisible et en pics — je bascule une charge dessus quand elle en a vraiment besoin, pas avant.
Rien de tout ça n'est un dogme. Une inférence en edge mondial ou une vraie capacité en pics imprévisibles justifie de partir sur un hyperscaler ou du serverless dès le premier jour. Pour la plupart des premiers produits, l'option simple et prévisible reste la plus sûre.
06 — Être prêt à lancer
Retour à la vraie question du début : ce qui fait monter la facture quand les utilisateurs arrivent. L'argent n'est qu'une facette de la même question — qu'est-ce que vous n'avez pas encore vérifié ? Un coût caché non budgété et une faille non testée viennent du même angle mort, visible seulement avec de vrais utilisateurs, de vrais paiements, du vrai trafic.
Je vérifie les deux, même discipline sous deux formes : coûts fixes ou d'usage, facturation à l'opération ou au forfait — à nommer avant de lancer, comme savoir qui peut lire les données d'un autre client.
Sécurité et données : [Les 6 choses que je vérifie avant de mettre une app construite avec l'IA en production](/blog/ai/six-signaux-alerte-app-ia). Ici, le volet financier.
Si vous voulez aller plus loin
Je relis des applications construites avec l'IA ou en vibe coding avant leur mise en production.
Commencer ici
Trust Report
Une revue automatisée de votre app et de son code, réalisée avec mes outils d'analyse. Vous obtenez les principaux risques, ce qui mérite l'attention avant le lancement et ce qui peut attendre. Si vous souhaitez parcourir les résultats ensemble, une revue avec moi est disponible en option.
Architecture, paiements, accès, données clients, garde des clés de déploiement, logiciels tiers, et une recommandation de mise en production documentée par un CTO humain.
I click "reject all" on almost every cookie banner I see.
On mikbry.com, I'd rather not ask you the question at all: I simply don't use the trackers that would require your consent.
I measure what I need to know if the site is useful — how many pages get read, which buttons get used, and roughly when. I don't need to know it was you, and I won't recognize you next time you're back.
A cookie banner is not a privacy strategy. Collecting less data is. That's the idea this piece walks through — not "banners are theatre," but what a site like this one actually needs to measure, and what it looks like to build for that instead of asking permission for more.
What this article covers
1. [Why there's no banner](#s1)
2. [What I actually measure](#s2)
3. [What I deliberately don't collect](#s3)
4. [How you can verify it](#s4)
5. [What this choice costs the business](#s5)
6. [For the technical reader](#s6)
7. [Trust Report and Audit](#s7)
01 — Why there's no banner
A banner typically appears when a website uses cookies or other trackers that require your consent — for advertising, cross-site tracking, or certain audience-measurement tools. mikbry.com doesn't use trackers that would require your consent to measure its audience. That's why there's no cookie banner: this is a cookieless website by design, not by omission.
A strictly-necessary cookie to keep you logged in can be used without asking your consent — that exemption has always existed. When a site uses trackers that do not qualify for an exemption, it has to obtain consent before using them. A banner is simply the most common way to ask.
None of this is unique to me. A crop of 2026 analytics tools — Plausible, Fathom, Cloudflare Web Analytics, Umami, PostHog's cookieless mode — offer measurement modes without ad cookies or persistent individual tracking. Depending on their configuration and the data they process, this can let a site avoid requiring consent in the first place. That's the same choice mikbry.com makes. I prefer to collect less data than to ask permission to collect more.
Here's the minimum I actually need to know if this site is working. Everything past that is decoration I've chosen not to add.
**Analytics.** mikbry.com counts pages read and buttons clicked, aggregated by the hour — not "someone read /about between 3 and 4 PM Paris time" as a stand-in for a specific visitor, genuinely just that count. No visitor identifier is attached, and no session connects one page view to the next. I don't know it was you. I won't recognize you next time you're back.
**Security logs — a separate thing.** The web server keeps the same basic records any host keeps for security and abuse prevention: an IP address, a timestamp, the requested URL, the user agent. These are retained for 7 days, then deleted. This is not analytics — they are not used to analyse visitor behaviour, they exist only to catch abuse or investigate an incident, and they are never merged with the aggregate counts above.
The only place I learn something specific about a visitor is the place they told me to: if you send me an idea or ask for a report, that's a form you filled in and a button you pressed — not something I was watching happen.
03 — What I deliberately don't collect
No ad network, on this site or feeding into one elsewhere. No cross-site tracking — nothing here follows you to another site, and nothing brings a profile built on another site to this one. No session recording, no heatmaps, no tool that replays how you moved your mouse. No individual profile of any kind: there's no record that represents "you," only aggregate counts that represent some number of visits.
The analytics counters, security logs, and form submissions described here are hosted in France. Nothing gets shipped to an ad platform in another jurisdiction, because there's no ad platform in the loop.
04 — How you can verify it
I'd rather you check this than take my word for it.
A safe first check
Open your browser's DevTools (right-click anywhere on the page → Inspect), go to the Network tab, and reload any page on mikbry.com. Look for two things: no tracking or advertising cookie being set, and no requests going out to a company like Google Analytics or Facebook. Then check the Application tab → Cookies for this site.
There's also a small data file at mikbry.com/.well-known/privacy.json that lists this out in one place — more in the technical section below.
None of this proves the whole site is safe — it proves the specific thing it's claiming: no visible third-party tracker and no requests to a third-party advertising or analytics platform.
05 — What this choice costs the business
I want to be honest about the price.
There's no remarketing pixel, so I can't show an ad to someone who visited and left. There's no cross-site attribution, so I can't tell which article led to which paid Trust Report three weeks later — I get an hourly count, not a funnel. There's no audience segment to export elsewhere. If growth marketing is your model, this stack is a real handicap.
It's a tradeoff I make on purpose, for a business shaped a specific way: a small number of buyers, sold to directly, over conversations rather than ad campaigns. I don't need to correlate a click three weeks ago to a sale today — I already know who I talked to and why they bought. What I need is for the people who land here to trust what they're reading enough to email me, and a site that quietly profiles them while claiming to be trustworthy would work against that. The signal I care about is quality of relationship, not quantity of retargetable traffic.
06 — For the technical reader
**Tracking.** `/e/track` and `/e/submit` are the two first-party endpoints the site uses for edge tracking and form submissions. Both terminate on our Caddy-fronted VPS; neither calls a third-party service. `/e/track` fires a fire-and-forget request on page load — no cookie set, no browser storage touched — and lands as an anonymous hourly bucket, not a per-visitor record. `/e/submit` carries only the fields a given call-to-action explicitly declares. Security logs (Caddy — IP, timestamp, URL, user agent) are retained separately, 7 days, for abuse prevention only.
**Legal basis.** In France, the rules specific to cookies and other trackers come from Article 82 of the Loi Informatique et Libertés, which transposes the ePrivacy Directive. GDPR then applies whenever the processing involves personal data, and defines what a valid consent looks like. The data-subject rights described on the [privacy page](/privacy) — access, rectification, erasure, restriction, portability, objection — come from GDPR Articles 15–22.
Sources:CNIL — what the law says about cookies and trackers confirms Article 82 as the specific consent rule and its exemptions, including for strictly-necessary purposes and certain audience-measurement configurations.
**Manifest.** [`/.well-known/privacy.json`](/.well-known/privacy.json) publishes the claims above in machine-readable form: what's tracked, what isn't, hosting jurisdiction, log retention in days.
**Header stack.** mikbry.com is missing two response headers that would tighten this further: `Referrer-Policy: strict-origin-when-cross-origin` (so full URLs don't leak into outbound-link referrer data) and a `Permissions-Policy` including `browsing-topics=()` (an explicit opt-out of the Topics API). It also doesn't emit `Content-Signal: search=yes, ai-retrieval=yes, ai-train=no` — a voluntary, still-emerging convention ([content-signals.org](https://content-signals.org/)), not a security or privacy standard; adopting it is a forward-looking signal, not a compliance claim. These headers live in the shared Caddy configuration we run across our infrastructure, applied centrally rather than duplicated per project.
This is how I design my own products and the systems I put in place for my clients: minimal analytics, European infrastructure where relevant, explicit consent, and verifiable transparency.
07 — Trust Report and Audit
The trust cornerstone piece on this site is about boundaries an AI-built app crosses without anyone deciding it should — payments, authentication, other people's data. The check I ran on my own site while writing this is the same one: not "does it work," but "what actually happens, and did anyone agree to it."
A cookie banner is not a privacy strategy. Collecting less data is — and that's a decision, not a default, the same way checking what an app actually does before launch is a decision, not a default.
If you want the security and access side of that check, [Six things I check before trusting an AI-built app in production](/blog/ai/six-ai-built-app-red-flags) covers it. This piece covers the privacy side. A Trust Report or an Audit puts both under one review before you launch.
If you want to go further
I review AI-built and vibe-coded applications before they go into production.
Start here
Trust Report
An automated review of your app and its code, using my analysis tools. You get the main risks, what deserves attention before launch, and what can wait. If you want to discuss the findings, a review with me is available as an option.

Je clique presque toujours sur « tout refuser ».
Sur mikbry.com, je préfère éviter de vous poser la question : je n'utilise tout simplement pas les traceurs qui nécessiteraient votre consentement.
Je mesure ce dont j'ai besoin pour comprendre si le site est utile : combien de pages sont lues, quels boutons sont utilisés, et à quel moment. Je n'ai pas besoin de savoir que c'était vous, ni de vous reconnaître lors de votre prochaine visite.
Une bannière cookies n'est pas une stratégie de confidentialité. Collecter moins de données, oui. C'est l'idée de ce texte — pas « les bannières sont du théâtre », mais ce qu'un site comme celui-ci a réellement besoin de mesurer, et à quoi ça ressemble de construire pour ça plutôt que de demander la permission d'en faire plus.
Ce que couvre cet article
1. [Pourquoi il n'y a pas de bannière](#s1)
2. [Ce que je mesure réellement](#s2)
3. [Ce que je ne collecte volontairement pas](#s3)
4. [Comment vous pouvez le vérifier](#s4)
5. [Ce que ce choix me fait perdre commercialement](#s5)
6. [Pour les techniciens](#s6)
7. [Trust Report et Audit](#s7)
01 — Pourquoi il n'y a pas de bannière
Une bannière apparaît généralement lorsqu'un site utilise des cookies ou d'autres traceurs qui nécessitent votre consentement — par exemple pour la publicité, le suivi entre sites ou certains outils de mesure d'audience. mikbry.com n'utilise pas de traceurs nécessitant un consentement préalable pour mesurer son audience. C'est pour cela qu'il n'y a pas de bannière cookies.
Un cookie strictement nécessaire pour vous garder connecté peut être utilisé sans consentement — cette exception a toujours existé. Lorsqu'un site utilise des traceurs qui ne rentrent pas dans une exemption, il doit obtenir votre consentement avant de les utiliser. La bannière est simplement la manière la plus courante de le demander.
Rien de tout ça n'est propre à ce site. Une génération d'outils d'analytics 2026 — Plausible, Fathom, Cloudflare Web Analytics, Umami, le mode sans cookies de PostHog — propose des modes de mesure sans cookies publicitaires ni suivi individuel persistant. Selon leur configuration, cela peut permettre d'éviter le recueil du consentement. C'est le même choix que fait mikbry.com. Je préfère collecter moins de données plutôt que demander la permission d'en collecter davantage.
Sources :Plausible, Fathom et Cloudflare Web Analytics décrivent leurs modes de mesure sans cookies. Le cadre juridique est détaillé dans la section technique plus bas.
02 — Ce que je mesure réellement
Voici le minimum dont j'ai besoin pour savoir si ce site fonctionne. Tout le reste est du superflu que j'ai choisi de ne pas ajouter.
**Mesure d'audience.** mikbry.com compte les pages lues et les clics, agrégés par heure — pas « quelqu'un a lu /about entre 15 h et 16 h » comme substitut d'un visiteur précis, vraiment juste ce total. Aucun identifiant de visiteur n'y est attaché, aucune session ne relie une page vue à la suivante. Je ne sais pas que c'était vous. Je ne vous reconnaîtrai pas à votre prochaine visite.
**Journaux de sécurité — une autre chose.** Le serveur garde les mêmes traces basiques que tout hébergeur pour la sécurité et la prévention des abus : IP, horodatage, URL demandée, agent utilisateur. Conservées 7 jours, puis supprimées. Ce n'est pas de l'analytics — ils ne sont pas utilisés pour analyser le comportement des visiteurs, ils servent uniquement à repérer un abus ou enquêter sur un incident, et ne sont jamais fusionnés avec les totaux ci-dessus.
Le seul endroit où j'apprends réellement quelque chose de précis sur un visiteur, c'est celui où il me l'a dit lui-même : envoyer une idée ou demander un rapport, c'est un formulaire rempli et un bouton pressé — pas quelque chose que j'observais.
03 — Ce que je ne collecte volontairement pas
Aucun réseau publicitaire, ni sur ce site ni en amont d'un autre. Aucun suivi entre sites — rien ici ne vous suit ailleurs, et rien n'apporte ici un profil construit ailleurs. Aucun enregistrement de session, aucune heatmap, aucun outil qui rejoue le mouvement de votre souris. Aucun profil individuel : pas de fiche qui vous représente, seulement des totaux agrégés.
Les données d'analytics, les journaux de sécurité et les formulaires décrits ici restent hébergés en France. Rien ne part vers une plateforme publicitaire ailleurs, parce qu'il n'y en a pas dans la boucle.
04 — Comment vous pouvez le vérifier
Je préfère que vous vérifiiez ça plutôt que de me croire sur parole.
Premier test · sans risque
Ouvrez les DevTools (clic droit → Inspecter), onglet Réseau, et rechargez n'importe quelle page de mikbry.com. Cherchez deux choses : aucun cookie de pistage ou publicitaire posé, et aucune requête vers une entreprise comme Google Analytics ou Facebook. Vérifiez ensuite l'onglet Application → Cookies pour ce site.
Il y a aussi un petit fichier de données à mikbry.com/.well-known/privacy.json qui liste tout ça au même endroit — plus de détails dans la section technique plus bas.
Rien de tout ça ne prouve que le site entier est sûr — ça prouve la chose précise qu'il revendique : aucun traceur tiers visible et aucune requête vers une plateforme publicitaire ou analytique tierce.
05 — Ce que ce choix me fait perdre commercialement
Je veux être honnête sur le prix.
Pas de pixel de remarketing, donc impossible de montrer une pub à quelqu'un qui est passé et reparti. Pas d'attribution cross-site, donc impossible de dire quel article a mené à quel Trust Report payé trois semaines plus tard — j'ai un total horaire, pas un tunnel de conversion. Pas de segment d'audience à exporter ailleurs. Si votre modèle repose sur le growth marketing, cette pile est un vrai handicap.
C'est un compromis volontaire, pour une activité construite d'une façon précise : peu d'acheteurs, vendu directement, par conversation plutôt que par campagne. Je n'ai pas besoin de relier un clic d'il y a trois semaines à une vente d'aujourd'hui — je sais déjà à qui j'ai parlé et pourquoi. J'ai besoin que les gens qui atterrissent ici fassent assez confiance à ce qu'ils lisent pour m'écrire ; un site qui les profile discrètement tout en prétendant être digne de confiance jouerait contre ça. Le signal qui compte, c'est la qualité de la relation, pas le volume de trafic reciblable.
06 — Pour les techniciens
**Pistage.** `/e/track` et `/e/submit` sont les deux endpoints first-party que le site utilise pour le suivi edge et les soumissions de formulaires. Les deux terminent sur notre VPS Caddy ; aucun n'appelle un service tiers. `/e/track` envoie une requête « fire-and-forget » au chargement de la page — aucun cookie posé, aucun stockage touché — et arrive côté serveur en total horaire anonyme, pas en enregistrement par visiteur. `/e/submit` ne transporte que les champs qu'un CTA déclare explicitement. Les journaux de sécurité (Caddy) sont conservés séparément, 7 jours, uniquement pour la prévention des abus.
**Base légale.** En France, les règles spécifiques aux cookies et autres traceurs viennent notamment de l'article 82 de la loi Informatique et Libertés, qui transpose la directive ePrivacy. Le RGPD s'applique ensuite lorsque le traitement porte sur des données personnelles et définit notamment les conditions d'un consentement valide. Les droits décrits sur la [page confidentialité](/fr/privacy) — accès, rectification, effacement, limitation, portabilité, opposition — viennent des articles 15 à 22 du RGPD.
Sources :CNIL — ce que dit la loi sur les cookies et traceurs confirme l'article 82 comme règle de consentement spécifique et ses exceptions, notamment pour les finalités strictement nécessaires et certaines configurations de mesure d'audience.
**Manifeste.** [`/.well-known/privacy.json`](/.well-known/privacy.json) publie les affirmations ci-dessus sous forme lisible par machine : ce qui est pisté, ce qui ne l'est pas, la juridiction d'hébergement, la durée de conservation des journaux en jours.
**Pile d'en-têtes.** Il manque à mikbry.com deux en-têtes de réponse qui renforceraient encore cela : `Referrer-Policy: strict-origin-when-cross-origin` (pour éviter que des URL complètes fuitent dans le referrer des liens sortants) et un `Permissions-Policy` incluant `browsing-topics=()` (opt-out explicite de la Topics API). Il n'émet pas non plus `Content-Signal: search=yes, ai-retrieval=yes, ai-train=no` — une convention volontaire encore émergente ([content-signals.org](https://content-signals.org/)), qui n'est pas un standard de sécurité. L'adopter est un signal tourné vers l'avenir, pas une déclaration de conformité. Ces en-têtes vivent dans la configuration Caddy partagée que nous opérons sur notre infrastructure, appliquée de manière centrale plutôt que dupliquée par projet.
C'est la façon dont je conçois mes propres produits et les systèmes que je mets en place pour mes clients : analytics minimaux, infrastructure européenne quand c'est pertinent, consentement explicite et transparence vérifiable.
07 — Trust Report et Audit
L'article fondateur sur la confiance de ce site parle des frontières qu'une app construite avec l'IA franchit sans que personne ait décidé qu'elle le devait — paiements, authentification, données d'autrui. La vérification que j'ai faite sur mon propre site en écrivant ceci est la même : pas « est-ce que ça marche », mais « qu'est-ce qui se passe réellement ».
Une bannière cookies n'est pas une stratégie de confidentialité. Collecter moins de données, oui — et c'est une décision, pas un défaut, de la même façon que vérifier ce qu'une app fait vraiment avant de la lancer est une décision, pas un défaut.
Le volet sécurité et accès de cette même vérification, c'est [Les 6 choses que je vérifie avant de mettre une app construite avec l'IA en production](/blog/ai/six-signaux-alerte-app-ia). Celui-ci couvre le volet vie privée. Un Trust Report ou un Audit passent les deux au crible avant le lancement.
Si vous voulez aller plus loin
Je relis des applications construites avec l'IA ou en vibe coding avant leur mise en production.
Commencer ici
Trust Report
Une revue automatisée de votre app et de son code, réalisée avec mes outils d'analyse. Vous obtenez les principaux risques, ce qui mérite l'attention avant le lancement et ce qui peut attendre. Si vous souhaitez parcourir les résultats ensemble, une revue avec moi est disponible en option.
Architecture, paiements, accès, données clients, garde des clés de déploiement, logiciels tiers, et une recommandation de mise en production documentée par un CTO humain.
---
# https://mikbry.com/blog/ai/why-ai-products-feel-replaceable/
# Why your AI-built product still feels replaceable
Mik Bry · 2026-08-21 · ~9 min read · AI · Authorship
One of my own projects still runs. Nothing is technically wrong with it. Nobody complains about it. And it never quite became the thing I meant to build — I can't even point to the moment that happened, because there wasn't one. I handed an AI agent a pile of specifications and let it work. It followed every one of them. What it didn't have was my reason for building the thing in the first place, and eventually that gap showed up in the product itself: correct, competent, and quietly not what anyone had actually asked for.
It would be tidy to blame the prompt. I don't think that's what happened. Around the same time, I pointed a similar kind of AI agent at a different job — one where I'd already written a test suite that spelled out, case by case, what "finished" meant. It hit that target cleanly, overnight, while I was asleep. Same category of tool. Two very different mornings. What changed wasn't the AI — it was whether I had already decided, in a form the machine could actually check, what I wanted.
When nothing in the product reflects a specific person, problem or point of view, another team with the same tools can rebuild something that looks very similar. That is what replaceable means.
What this article covers
1. [A competent product nobody quite asked for](#s1)
2. [The same kind of AI, pointed at a real target](#s2)
3. [Why AI converges so well when the target already exists](#s3)
4. [The moat was never the tool](#s4)
5. [Building the software is only one part](#s5)
6. [Authorship doesn't disappear — it moves up](#s6)
01 — A competent product nobody quite asked for
Here's what "specifications without vision" actually looks like from the inside, because it's easy to hear that phrase and picture something obviously broken. It isn't. A specification tells a builder what to build: which screen, which button, which field. It doesn't tell anyone why this feature matters more than that one, who is supposed to open the thing at 9pm on a Tuesday, or what still has to hurt enough that they come back tomorrow. My drifting project had plenty of the first kind of instruction and almost none of the second.
The agent didn't fail at any individual task. It succeeded at all of them, one after another, in order. The result was a house built exactly to a floor plan that nobody had actually decided to live in. Every room was where the drawing said it should be. I just hadn't picked a person to hand the keys to, so nothing in the house pointed anywhere in particular. That's a strange kind of failure — there's no error message for it, no failing test, nothing a reviewer would flag. The code works. Nobody had told it, clearly enough, who any of this was for. That part was on me, not on the agent.
02 — The same kind of AI, pointed at a real target
This isn't a controlled experiment. Different projects, different weeks — no scientist would sign off on calling it that, and I'm not going to. But it's a clean enough comparison that I stopped being able to blame the tool for the first project's drift.
Both projects ran through the same internal system I use to coordinate coding agents day to day — the tests, the reviews, the integration checks, the whole apparatus. That system is [its own story, for another time](/blog/ai/ai-code-review-human-bottleneck/). What matters here is what I fed it: two different kinds of instruction.
The second project had a [test suite](/blog/kb/build-vs-tests/) before the agent ever touched a line of code — cases that would pass, cases that were supposed to fail, and a clear line between the two. The agent worked through it the way water finds the bottom of a container: fast and unglamorous. By morning it had converged on exactly what the tests described. I hadn't watched a single step of it happen, and I didn't need to.
The agent performed best when the purpose and definition of "done" — one plain sentence saying what has to be true for the work to count — had already been authored. When I supplied instructions without a purpose, competent execution drifted. That's the whole finding, and it's smaller than it sounds — but it's mine, pulled from my own work, not from a hot take I read this week.
03 — Why AI converges so well when the target already exists
For a growing class of software products, writing the code is no longer the most expensive part. I'm not going to pretend that's a loss — I spent a good chunk of my career doing the parts of coding I no longer have to do by hand, and I don't miss most of them.
This is also why AI is so good at rebuilding things that already exist. Clone a familiar app, copy a competitor's feature, reimplement something whose shape is already public — an agent will chew through that with real competence, because the intelligence in the task was never the coding. It was the original decision, made by someone else, that this specific thing should exist and work this particular way. The agent inherits that decision. It doesn't have to make one.
What AI is making dramatically cheaper is the middle of the process: turning a product decision into working software. That was the hard, slow, expensive part, and it's fair to be glad it's cheaper now. What AI hasn't made cheap in the same way are the two ends of the process — the decision that a specific thing should exist, for a specific person, for a specific reason, and later, the decision that it's actually safe to hand to that person. My drifting project had a machine that could do the middle brilliantly. It never once had someone hand it the front end of that: a person, a reason, a "this, not that."
04 — The moat was never the tool
Every founder who's watched an AI-built product underperform has heard the standard answer by now: the real moat isn't the app, it's the data, the distribution, the domain knowledge, the brand. That list is correct. It's also one level too shallow — it names the symptoms of the thing without naming where any of them actually come from.
Take domain understanding. That's not something you research your way into over a weekend — it's what's left over after someone cared about one specific person's specific problem long after it stopped being interesting to think about. Or workflow fit: that comes from watching what a user actually does at their desk, not from what looks good in a demo. Even the data everyone points to as a moat only compounds into something useful because somebody decided, ahead of time, what was worth keeping and why. A database doesn't get valuable by filling up on its own.
Agents can turn those advantages into software, workflows and features very effectively once someone has defined the job. But the advantage itself comes earlier: from understanding who the product is for, what matters to them, and why. What separates a real moat from a replaceable product isn't a capability gap — it's whether someone had already decided, before any of it got built, who this was for and why it mattered. Most of those durable advantages eventually trace back to that decision. Not to the code that came after it.
05 — Building the software is only one part
AI has made it much cheaper to turn a product decision into working software. That's a significant change, but it can also distort where founders put their attention.
The code is only one part of a product.
Someone still has to find a problem worth solving, understand how people deal with it today, decide which part matters enough to change, explain the product in words those people recognise, and find a way to reach them.
None of that happens automatically because the implementation got easier.
In fact, the cheaper it becomes to build, the easier it is to spend months producing features nobody asked for. When writing another feature costs a few prompts instead of a few weeks of engineering, saying **no** becomes more important, not less.
Marketing belongs in this loop too. Not advertising as an afterthought, but the work of understanding how a customer describes the problem, what makes them pay attention, what alternative they compare you with, and why they would trust you enough to try something new.
That's product work. So is talking to users. So is watching what they actually do after launch and changing your assumptions when reality disagrees.
AI can accelerate all of those activities. It can analyse interviews, draft positioning, explore competitors and generate experiments. But it cannot remove the need to decide what evidence matters and what you are going to do about it. And you can't recover that decision by reviewing harder afterwards. The more familiar a tool gets, the less carefully we check it — people reviewing AI-written code approve more and comment less the longer they've been at it.
Coding was always a means — an invented way to make a computer do what someone wanted without wiring transistors by hand. As AI makes implementation cheaper, nothing essential is lost — a means is supposed to get cheaper. Authorship was never a means. It's the reason a means gets used at all: the decision that this specific thing should exist, for this specific person, for this specific reason. Making the builder faster doesn't answer that question. A faster compiler can execute a program sooner; it still doesn't decide what the program should do.
If AI keeps getting better at authorship-shaped work too — sensing what a market wants, drafting the plan, choosing which feature ships first — that decision doesn't vanish. It moves up a level. Someone still has to decide what the system itself should be trying to do, and for whom. On my drifting project, the fix wasn't a smarter agent. It was me finally showing up with an answer to "for whom, and why" — the one input no amount of additional competence was ever going to generate on its own.
Every check we run — tests passing, tidy code, a careful review — is a bet on the same question: did the thing work for the person you built it for? A machine can help you answer that question, but it can't own the answer — it only has the checkboxes. Knowing what "good" means for a real person was always yours.
Authorship isn't writing every line. It's remaining responsible for the direction of the product: who it's for, what problem you're choosing to solve, what you learn from the people using it, how you reach the next customer, and which direction you take when reality disagrees with the original plan.
The prompt is one sentence. The decision behind it still has to come from someone. That someone is you.
If you want to go further
I review AI-built and vibe-coded applications before they go into production.
Start here
Trust Report
An automated review of your app and its code, using my analysis tools. You get the main risks, what deserves attention before launch, and what can wait. If you want to discuss the findings, a review with me is available as an option.
---
# https://mikbry.com/blog/ai/produit-ia-remplacable/
# Pourquoi votre produit construit avec l'IA semble générique
Mik Bry · 2026-08-21 · lecture ~10 min · IA · Vision

Un de mes propres projets tourne encore aujourd'hui. Rien n'y est techniquement cassé. Personne ne s'en plaint. Et il n'est jamais tout à fait devenu ce que je voulais construire — je serais incapable de désigner le moment précis où cela a dérapé, parce qu'il n'y en a pas eu. J'ai donné à un agent IA une pile de spécifications et je l'ai laissé travailler. Il les a toutes suivies, une par une. Ce qui lui manquait, c'était la raison pour laquelle je voulais construire ce produit. Cet écart a fini par se voir dans le produit lui-même. Le résultat était correct, techniquement solide, mais il ne répondait vraiment au besoin de personne.
Ce serait pratique d'accuser le prompt. Je ne crois pas que ce soit cela. À peu près à la même période, j'ai lancé un agent du même genre sur un autre chantier — celui-là avait déjà une suite de tests qui définissait, cas par cas, ce que voulait dire « terminé ». Il a atteint cette cible proprement, pendant la nuit, sans que je surveille quoi que ce soit. Même famille d'outils. Deux matins radicalement différents. Ce qui avait changé, ce n'était pas l'IA — c'était le fait d'avoir, ou non, déjà décidé, sous une forme que la machine pouvait vérifier, ce que je voulais vraiment.
Quand rien dans le produit ne reflète un utilisateur, un problème ou un point de vue précis, une autre équipe disposant des mêmes outils peut produire un résultat très similaire — un produit générique de plus.
Ce que couvre cet article
1. [Un produit fonctionnel que personne n'avait vraiment demandé](#s1)
2. [La même IA, avec une cible claire](#s2)
3. [Pourquoi l'IA converge si bien quand la cible existe déjà](#s3)
4. [Le vrai avantage concurrentiel n'a jamais été l'outil](#s4)
5. [Construire le logiciel n'est qu'une partie du travail](#s5)
6. [L'auteur ne disparaît pas — il monte d'un niveau](#s6)
01 — Un produit fonctionnel que personne n'avait vraiment demandé
Voilà à quoi ressemble, de l'intérieur, « des spécifications sans vision » — parce qu'entendu comme cela, on imagine facilement un produit visiblement cassé. Ce n'est pas le cas. Un cahier des charges dit à un développeur quoi construire : quel écran, quel bouton, quel champ. Il ne dit à personne pourquoi cette fonctionnalité compte plus qu'une autre, qui est censé ouvrir l'application à 21h un mardi, ni quel problème doit encore le gêner assez pour qu'il revienne le lendemain. Mon projet qui a dérivé avait beaucoup de la première catégorie d'instructions, et presque aucune de la seconde.
L'agent n'a échoué sur aucune tâche individuelle. Il les a toutes réussies, l'une après l'autre, dans l'ordre. Le résultat ressemble à une maison construite exactement selon un plan que personne n'avait vraiment décidé d'habiter. Chaque pièce était là où le plan le disait. Je n'avais simplement jamais choisi à qui remettre les clés, alors rien dans la maison ne semblait destiné à quelqu'un en particulier. C'est un échec étrange : pas de message d'erreur, pas de test qui échoue, rien qu'un relecteur pourrait signaler. Le code fonctionne. Personne ne lui avait dit, assez clairement, pour qui tout cela existait — alors rien dedans ne pointait vers un quelconque utilisateur. Cette partie-là, c'était la mienne, pas celle de l'agent.
02 — La même IA, avec une cible claire
Ce n'est pas une expérience contrôlée. Deux projets différents, deux semaines différentes — aucun scientifique n'appellerait ça une expérience, et moi non plus. Mais la comparaison est assez nette pour que je ne puisse plus accuser l'outil du dérapage du premier projet.
Les deux projets tournaient dans le même système interne que j'utilise au quotidien pour coordonner des agents de code — les tests, les revues, les vérifications d'intégration, tout le système. [Ce système mérite son propre article, mais ce n'est pas le sujet ici](/blog/ai/arreter-tout-relire-code-ia/). Ce qui compte, c'est ce que je lui ai confié : deux types d'instructions très différents.
Le second projet avait une [suite de tests](/blog/kb/build-vs-tests-fr/) avant même que l'agent touche une ligne de code — des cas censés passer, des cas censés échouer, une frontière claire entre les deux. Avec cet objectif clair, l'agent a avancé vite et sans hésitation. Au matin, il avait convergé exactement vers ce que les tests décrivaient. Je n'avais surveillé aucune étape, et je n'en avais pas besoin.
L'agent a été le plus efficace quand l'objectif et la définition de « terminé » — une phrase claire disant ce qui doit être vrai pour que le travail compte comme fini — avaient déjà été posés par un humain. Quand je lui ai donné des instructions sans objectif clair, l'exécution — soignée pourtant — a dérivé. C'est tout le constat, et il est plus modeste qu'il n'en a l'air — mais il est à moi, tiré de ma propre expérience, pas d'une opinion à la mode lue cette semaine.
03 — Pourquoi l'IA converge si bien quand la cible existe déjà
Pour de plus en plus de produits logiciels, écrire le code n'est plus la partie la plus coûteuse. Je ne vais pas prétendre que c'est un mal — j'ai passé une bonne partie de ma carrière à faire à la main des tâches que je n'ai plus besoin de faire à la main, et la plupart ne me manquent pas.
C'est justement pour cela que l'IA excelle à reconstruire ce qui existe déjà. Cloner une application connue, copier la fonctionnalité d'un concurrent, réimplémenter un comportement dont la forme est déjà publique — un agent peut l'exécuter très efficacement, parce que l'intelligence de la tâche n'a jamais été dans le code. Elle était dans la décision d'origine, prise par quelqu'un d'autre, que cette fonctionnalité précise devait exister et fonctionner de cette manière précise. L'agent hérite de cette décision. Il n'a pas à en prendre une lui-même.
Ce que l'IA rend beaucoup moins coûteux, c'est le coeur du processus : transformer une décision produit en logiciel qui tourne. C'était vraiment la partie longue et coûteuse, et c'est bien qu'elle coûte moins cher aujourd'hui. Ce qu'elle n'a pas repris, ce sont les deux extrémités du processus — la décision qu'une chose précise doit exister, pour une personne précise, pour une raison précise, et, plus tard, la décision que ce logiciel est suffisamment fiable pour être confié à cette personne. Mon projet qui a dérivé avait une machine capable d'exécuter brillamment cette partie centrale. Elle n'a jamais eu, à aucun moment, quelqu'un pour lui donner le début de la phrase : une personne, une raison, un « ceci, et pas autre chose ».
04 — Le vrai avantage concurrentiel n'a jamais été l'outil
Tout fondateur qui a vu un produit construit avec l'IA se révéler décevant a déjà entendu la réponse habituelle : le vrai avantage, ce n'est pas l'application, ce sont les données, la distribution, la connaissance du métier, la marque. Cette liste n'est pas fausse. Elle s'arrête juste un cran trop tôt — elle nomme les symptômes sans dire d'où ils viennent réellement.
La connaissance d'un métier ne s'acquiert pas en un week-end de recherche. Elle vient du temps passé à comprendre en profondeur le problème concret de personnes réelles, bien après que le sujet a cessé d'être nouveau ou excitant. Ou l'intégration dans un flux de travail : cela vient du fait d'avoir observé ce qu'un utilisateur fait vraiment à son bureau, pas ce qu'une démo montre sur une scène. Même les données qu'on présente souvent comme un avantage ne deviennent réellement utiles que parce que quelqu'un a décidé ce qui méritait d'être conservé, et pourquoi. Une base de données ne devient pas précieuse en se remplissant toute seule.
Les agents peuvent très bien transformer ces avantages en logiciel, en fonctionnalités ou en processus une fois le problème clairement défini. Mais l'avantage lui-même vient d'avant : comprendre pour qui le produit existe, ce qui compte pour cette personne et pourquoi. Ce qui sépare un vrai avantage d'un produit générique n'a jamais été une question de compétence — c'est de savoir si quelqu'un avait déjà décidé, avant que tout cela soit construit, pour qui c'était et pourquoi cela comptait. La plupart de ces avantages durables remontent finalement à la même décision : quelqu'un a compris pour qui le produit existait et pourquoi.
05 — Construire le logiciel n'est qu'une partie du travail
L'IA a rendu beaucoup moins coûteux le fait de transformer une décision produit en logiciel qui tourne. C'est un changement important — mais il peut aussi détourner l'attention des fondateurs de l'essentiel.
Le code n'est qu'une partie du produit.
Il faut toujours quelqu'un pour trouver un problème qui vaut la peine d'être résolu, comprendre comment les gens s'en débrouillent aujourd'hui, décider quelle partie mérite vraiment d'être changée, expliquer le produit avec des mots que ces gens reconnaissent, et trouver un moyen de les atteindre.
Rien de tout cela n'arrive automatiquement parce que l'implémentation est devenue plus facile.
Plus le coût de construction baisse, plus il devient facile de passer des mois à produire des fonctionnalités que personne n'a demandées. Quand écrire une fonctionnalité de plus coûte quelques prompts au lieu de plusieurs semaines de développement, savoir dire **non** devient plus important, pas moins.
Le marketing fait partie de cette boucle lui aussi. Pas la publicité ajoutée après coup, mais le travail qui consiste à comprendre comment vos clients décrivent leur problème, ce qui capte leur attention, à quelles alternatives ils vous comparent et pourquoi ils vous feraient assez confiance pour essayer quelque chose de nouveau.
Ça, c'est du travail produit. Parler aux utilisateurs aussi. Observer ce qu'ils font vraiment après le lancement, et revoir ses hypothèses quand la réalité les contredit — cela aussi.
L'IA peut accélérer chacune de ces activités. Elle peut analyser des entretiens, rédiger un positionnement, explorer la concurrence et proposer des expérimentations. Mais elle ne supprime pas la nécessité de décider quelles preuves comptent et ce qu'on va en faire. Et vous ne pouvez pas rattraper cette décision en relisant plus attentivement après coup. Plus un outil devient familier, moins on le vérifie soigneusement — les relecteurs de code écrit par l'IA approuvent davantage et commentent moins à mesure qu'ils en relisent.
06 — L'auteur ne disparaît pas — il monte d'un niveau
Coder a toujours été un moyen — une façon inventée de faire faire à un ordinateur ce que quelqu'un voulait, sans câbler des transistors à la main. À mesure que l'IA rend l'implémentation moins coûteuse, ce moyen devient simplement plus accessible. Et c'est très bien ainsi. Rendre un moyen technique moins coûteux n'enlève rien à ce qui donne au produit sa direction. La vision — la décision qu'une chose précise doit exister, pour une personne précise, pour une raison précise — n'a jamais été un moyen. C'est la raison pour laquelle un moyen est utilisé, tout court. Accélérer la construction ne rapproche pas de cette décision. Un compilateur plus rapide peut exécuter plus vite un programme déjà défini ; il ne décide pas de ce que ce programme devrait faire.
Si l'IA continue de progresser aussi sur ce qui ressemble à de la vision — détecter ce qu'un marché attend, esquisser le plan, choisir quelle fonctionnalité sort en premier — cette décision ne disparaît pas. Elle change de niveau. Quelqu'un doit encore décider ce que le système lui-même essaie de faire, et pour qui. Sur mon projet qui a dérivé, la solution n'était pas un agent plus intelligent. C'était moi, enfin présent pour répondre à « pour qui, et pourquoi » — une décision que davantage de capacité technique n'aurait pas prise à ma place.
Tout ce qu'on vérifie — les tests qui passent, un code propre, une relecture attentive — est un pari sur la même question : est-ce que ce qu'on a construit a vraiment servi la personne pour qui on le construisait ? Une machine peut vous aider à y répondre, mais elle ne peut pas en assumer la responsabilité — elle n'a que les cases à cocher. Savoir ce que « bien » veut dire pour une personne réelle, c'est votre rôle depuis le début.
La vision, ce n'est pas écrire chaque ligne. C'est rester responsable de la direction du produit : à qui il s'adresse, quel problème vous choisissez de résoudre, ce que vous apprenez de ceux qui l'utilisent, comment vous atteignez le client suivant, et quelle direction vous prenez quand la réalité contredit le plan de départ.
Le prompt peut tenir en une phrase. La décision qu'il contient doit encore venir de quelqu'un. Et ce quelqu'un, c'est encore vous.
Si vous voulez aller plus loin
Je relis des applications construites avec l'IA ou en vibe coding avant leur mise en production.
Commencer ici
Trust Report
Une revue automatisée de votre app et de son code, réalisée avec mes outils d'analyse. Vous obtenez les principaux risques, ce qui mérite l'attention avant le lancement et ce qui peut attendre. Si vous souhaitez parcourir les résultats ensemble, une revue avec moi est disponible en option.
Architecture, paiements, accès, données clients, garde des clés de déploiement, logiciels tiers, et une recommandation de mise en production documentée par un CTO humain.
Your app builds. Your AI agent says it's done. Isn't that the same as working?
Not quite. That gap is where problems in AI-built apps can stay invisible for surprisingly long. A build passing tells you something real — just not the thing most people assume it tells you.
This article is about that gap: what a build actually checks, what a test actually checks, and why the difference matters more once your agent is the one telling you "it passes."
What this article covers
1. [What "build" and "tests" actually mean](#s1)
2. [Why a green build doesn't prove the product works](#s2)
3. [What good test coverage looks like](#s3)
4. [What you can safely ask your AI agent](#s4)
01 — What "build" and "tests" actually mean
A "build" is the step that turns your source code into something that can actually run. Depending on how the project is set up, that step might check that the code compiles, that the types line up, that the formatting rules pass, that images and other assets get generated correctly — and sometimes, depending on configuration, it runs a batch of tests too. What exactly counts as "the build" is a project-by-project decision, not a fixed universal list.
"Tests" are a different kind of check. They don't ask whether the code is put together correctly — they ask whether the *behaviour* is correct. Does the sign-in screen actually let the right person in and keep the wrong person out? Does the payment get recorded when the card is charged? Does one customer's data actually stay invisible to another customer?
Here's the clearest way to picture the difference: *"Like writing English with no grammatical errors, so the words are correct on their own — but read together they make no sense."* A build is the grammar check — every word spelled correctly, every sentence structurally sound. Tests are the meaning check — does the paragraph actually say what you meant it to say.
**Build** answers: can this software be assembled at all? **Tests** answer: does the behaviour we actually care about still work? Both checks are useful. Neither one substitutes for the other.
02 — Why a green build doesn't prove the product works
"The build passed" is a narrower claim than it sounds. It means the checks included in that particular build configuration passed — nothing more. A green build does not prove sign-in works. It does not prove a payment is recorded correctly. It does not prove one customer can't see another customer's data. It proves that whatever was checked, checked out. If nothing checked the payment flow, the build has nothing to say about the payment flow — green or not.
The grammar analogy holds here too: a sentence with flawless spelling and grammar can still say something completely wrong, or nothing at all. The build is graded on grammar. Nobody graded it on meaning.
This gets sharper once an AI agent is the one writing and shipping the code. A conversational success message — human or AI — is not evidence. With AI, the volume and confidence of those messages can make that distinction especially easy to forget: "build passed," "done," "should be working now," delivered in the same reassuring tone whether or not anyone actually checked the thing that matters to your business. Your only signal of trouble becomes silence: no error, no warning, nothing wrong that anyone can see — until a paying customer hits a checkout button that quietly doesn't record the charge.
References: Martin Fowler's TestPyramid distinguishes an *automated build* — one that at least compiles and packages the software automatically — from a *self-testing build*, one whose automated tests give you real confidence the software behaves correctly. Kent C. Dodds' related principle, cited by web.dev, is worth carrying into any conversation with your AI agent about testing: "The more your tests resemble the way your software is used, the more confidence they can give you."
03 — What good test coverage looks like
You don't need comprehensive test coverage before you launch. You need coverage on the handful of things that would actually hurt you if they silently broke. For most founder-built apps, that's four flows:
- **Sign-in** — the right person gets in, the wrong person doesn't.
- **Payments** — a charge is recorded correctly, and a failed or declined payment doesn't quietly grant access anyway.
- **Data changes** — the change that happens in production is the one you meant, and it doesn't leak into another customer's account.
- **Account recovery** — a locked-out user can get back in through a path that an attacker can't walk through just as easily.
If meaningful tests exist for those flows, you have a much better starting point, even if the rest of the app has thin coverage. If none exist for those four, the build passing tells you very little about whether the app is safe to put in front of paying customers.
Tests are also only worth as much as how often they actually run. A test suite that exists but only gets run by hand, occasionally, when someone remembers, protects you far less than one that reruns automatically every time the code changes — the job usually called continuous integration. Tests are the questions; the automatic rerun is what makes sure the questions get asked every single time, not just the first time.
04 — What you can safely ask your AI agent
You don't need to write tests yourself, and you don't need to ask your agent to write them right now either. The first useful move is just finding out what already exists — and being precise about what "I found nothing" actually means. If your agent doesn't find a test for something, that means the search came up empty, not that the test is guaranteed not to exist somewhere it didn't look. Ask it to be honest about that distinction.
A safe prompt to paste into your AI coding tool
> "List the tests covering sign-in, payments, data changes, and account recovery. For each flow, tell me if you found no tests — don't assume none exist elsewhere. Point me to the test files. Don't write tests yet."
The prompt is deliberately read-only: it asks the agent to inspect and report, not to modify the project.
A build passing is real information — it tells you the app can be assembled. It was never meant to tell you whether it works for the four flows above, and treating it that way is where the trouble starts.
---
# https://mikbry.com/blog/kb/build-vs-tests-fr/
# Build vs tests : pourquoi « ça passe » ne veut pas dire « ça marche »

Le build de ton app passe. Ton agent IA te dit que c'est fait. C'est pareil que « ça marche », non ?
Pas tout à fait, et c'est souvent là que les problèmes passent inaperçus dans une app construite avec l'IA. Un build qui passe te dit quelque chose de réel — juste pas ce que la plupart des gens croient.
Cet article parle de cet écart : ce qu'un build vérifie vraiment, ce qu'un test vérifie vraiment, et pourquoi la différence compte davantage quand c'est ton agent qui t'annonce « ça passe ».
Ce que couvre cet article
1. [Ce que « build » et « tests » veulent vraiment dire](#s1)
2. [Pourquoi un build vert ne prouve pas que le produit fonctionne](#s2)
3. [À quoi ressemble une bonne couverture de tests](#s3)
4. [Ce que tu peux demander sans risque à ton agent IA](#s4)
01 — Ce que « build » et « tests » veulent vraiment dire
Un « build » est l'étape qui transforme ton code source en quelque chose capable de tourner. Selon la configuration du projet, cette étape peut vérifier que le code compile, que les types sont cohérents, que le formatage respecte les règles, que les images et autres fichiers sont bien générés — et parfois, selon la configuration, elle fait tourner un lot de tests aussi. Ce qui compte exactement comme « le build » est une décision propre à chaque projet, pas une liste universelle figée.
Les « tests » sont un type de vérification différent. Ils ne demandent pas si le code est assemblé correctement — ils demandent si le *comportement* est correct. Est-ce que l'écran de connexion laisse vraiment entrer la bonne personne et pas une autre ? Est-ce que le paiement est bien enregistré quand la carte est débitée ? Est-ce que les données d'un client restent vraiment invisibles pour un autre ?
> Imagine un texte sans aucune faute de grammaire : chaque mot est correct, chaque phrase est bien construite, mais l'ensemble ne veut rien dire.
>
> Le build vérifie en quelque sorte la grammaire. Les tests vérifient le sens : est-ce que le logiciel fait réellement ce que tu attends de lui ?
**Le build** répond à : est-ce que ce logiciel peut être assemblé, tout simplement ? **Les tests** répondent à : est-ce que le comportement qui compte vraiment fonctionne encore ? Les deux vérifications sont utiles. Aucune ne remplace l'autre.
02 — Pourquoi un build vert ne prouve pas que le produit fonctionne
« Le build est passé » est une affirmation plus étroite qu'elle n'en a l'air. Ça veut dire que les vérifications incluses dans cette configuration de build sont passées — rien de plus. Un build vert ne prouve pas que la connexion fonctionne. Il ne prouve pas qu'un paiement est bien enregistré. Il ne prouve pas qu'un client ne peut pas voir les données d'un autre client. Il dit simplement que les vérifications configurées n'ont pas échoué. Si rien n'a vérifié le paiement, le build n'a rien à dire sur le paiement — vert ou pas.
L'image de la grammaire tient toujours : une phrase avec une orthographe et une grammaire parfaites peut quand même dire quelque chose de complètement faux, ou ne rien dire du tout. Le build vérifie la grammaire, pas le sens.
Cet écart devient plus net quand c'est un agent IA qui écrit et déploie le code. Un message de succès — humain ou IA — n'est pas une preuve. Avec l'IA, le volume et l'assurance de ces messages rendent cette nuance particulièrement facile à oublier : « build réussi », « c'est fait », « ça devrait marcher maintenant », annoncés sur le même ton rassurant, que quelqu'un ait réellement vérifié la chose qui compte pour ton activité ou non. Ton seul signal d'alerte devient le silence : aucune erreur, aucun avertissement, rien de visible qui cloche — jusqu'à ce qu'un client payant clique sur un bouton de paiement qui, discrètement, n'enregistre rien.
Sources : Le TestPyramid de Martin Fowler distingue un *build automatisé* — qui compile et empaquette le logiciel automatiquement — d'un *build auto-testant*, dont les tests automatisés donnent une vraie confiance dans le comportement du logiciel. Le principe voisin de Kent C. Dodds, cité par web.dev, vaut la peine d'être gardé en tête dans toute conversation avec ton agent IA sur les tests (traduction) : « Plus tes tests ressemblent à la façon dont ton logiciel est réellement utilisé, plus ils peuvent t'inspirer confiance. »
03 — À quoi ressemble une bonne couverture de tests
Tu n'as pas besoin d'une couverture de tests exhaustive avant de lancer. Tu as surtout besoin de tests sur les quelques flux qui te feraient vraiment mal s'ils cassaient en silence. Pour la plupart des apps construites par un fondateur, ce sont quatre flux :
- **La connexion** — la bonne personne entre, la mauvaise n'entre pas.
- **Les paiements** — un paiement est bien enregistré, et un paiement refusé ou qui échoue ne débloque pas quand même l'accès en silence.
- **Les changements de données** — le changement qui a lieu en production est bien celui que tu voulais, et il ne fuite pas vers le compte d'un autre client.
- **La récupération de compte** — un utilisateur bloqué peut revenir par un chemin qu'un attaquant ne peut pas emprunter aussi facilement.
Si des tests sérieux existent pour ces flux, tu pars d'une bien meilleure base, même si le reste de l'app est peu couvert. S'il n'en existe aucun pour ces quatre flux, le fait que le build passe te dit très peu de choses sur le fait que l'app soit prête à accueillir des clients payants.
La valeur des tests dépend aussi de la fréquence à laquelle ils sont réellement exécutés. Une suite de tests qui existe mais qu'on ne lance qu'à la main, de temps en temps, quand quelqu'un y pense, te protège bien moins qu'une suite relancée automatiquement à chaque changement de code — ce qu'on appelle généralement l'intégration continue. Les tests posent les questions ; la relance automatique s'assure que ces questions sont posées à chaque fois, pas seulement la première.
04 — Ce que tu peux demander sans risque à ton agent IA
Tu n'as pas besoin d'écrire des tests toi-même, et tu n'as pas non plus besoin de demander à ton agent d'en écrire maintenant. Le premier geste utile, c'est juste de savoir ce qui existe déjà — et d'être précis sur ce que veut vraiment dire « je n'ai rien trouvé ». Si ton agent ne trouve pas de test pour quelque chose, ça veut dire que la recherche n'a rien donné, pas que le test est garanti de ne pas exister quelque part qu'il n'a pas regardé. Demande-lui d'être honnête sur cette nuance.
Le prompt à coller dans ton outil d'IA
> « Liste les tests qui couvrent la connexion, les paiements, les changements de données et la récupération de compte. Pour chaque flux, dis-moi si tu n'as trouvé aucun test — ne suppose pas qu'aucun n'existe ailleurs. Indique-moi les fichiers de test concernés. N'écris pas de tests pour l'instant. »
Ce prompt est volontairement en lecture seule : il demande à l'agent d'inspecter et de rendre compte, pas de modifier le projet.
Cet article fait partie de la série Launch Readiness KB : un concept à la fois pour comprendre ce que le Trust Report vérifie avant de lancer ton app, d'embaucher ou de lever des fonds. Chaque article se termine par quelque chose que tu peux demander à ton agent sans modifier le code.
---
# https://mikbry.com/blog/kb/dependencies/
# Your AI agent installed dozens of packages you never picked. Should you care?
Every time your AI coding tool adds a login form, a PDF export, a payment button, it will often rely on packages other developers already published rather than writing that code from scratch. That's a dependency. It can quickly mean dozens of direct packages and many more transitive ones.
That, by itself, isn't unusual. Most modern applications rely heavily on third-party packages. What's different with an agent is the review step. A human developer may pause to look at who maintains a package, how widely it's used, or whether it's still active. With an agent, that decision can happen as part of solving the immediate task without any explicit review. That's what "unreviewed" means here — not that the code is bad, but that nobody ever made that call.
What this article covers
1. [What is it?](#s1)
2. [Why should you care if you don't code?](#s2)
3. [What does good look like?](#s3)
4. [What can you safely ask your AI agent?](#s4)
01 — What is it?
Think of your app's dependencies as ingredients you buy, not ones you grow. A restaurant kitchen doesn't farm its own flour or churn its own butter — it orders ingredients from suppliers it trusts, and a good kitchen still checks what shows up in the delivery before it goes anywhere near a dish. Your app works the same way: almost nothing is grown from scratch, and code you didn't write is not automatically code that's fine to use unchecked.
There are two layers to this, and the second one is the part most founders never hear named. **Direct dependencies** are the packages your agent explicitly added — the ones that would show up if you asked it to list what your project depends on. **Transitive dependencies** are everything those packages need in turn, pulled in automatically, several layers deep, that nobody explicitly chose at any point. A project with twenty direct dependencies can easily carry several hundred transitive ones underneath — invisible unless something goes looking.
Either layer can enter the project without a separate moment where someone explicitly reviews the choice. That's the gap this article is about.
02 — Why should you care if you don't code?
Because this is a recognized category of real-world failure, not a fringe concern. [OWASP's 2025 Top 10](https://owasp.org/Top10/) — the closest thing security has to a shared list of "these are the ways applications actually get broken into" — renamed and broadened what used to be a narrower 2021 category ("Vulnerable and Outdated Components"). **A03:2025 Software Supply Chain Failures is one of the OWASP Top 10 categories.** The 2021 name is worth knowing only as history at this point; it's not the current framing.
Source: OWASP Top 10:2025, category A03 — Software Supply Chain Failures, owasp.org/Top10. Cited here as the current framing; A06:2021 Vulnerable and Outdated Components is its historical predecessor, not a separate current category.
There's also a risk specific to AI-assisted coding that didn't exist before agents started writing install commands on their own: **slopsquatting**. An AI model, asked to solve a problem, will sometimes confidently suggest a package name that sounds exactly right and doesn't exist — because the name is plausible, not because it's real. If an attacker notices which invented names models keep suggesting and registers those names first, the next agent that "helpfully" installs the package is installing whatever the attacker put there.
This isn't hypothetical. In January 2026, a security researcher at Aikido found a package called `react-codeshift` — a name no human ever registered, invented by an AI mashing together two real, unrelated packages (`jscodeshift` and `react-codemod`) into something that merely sounded plausible. The hallucinated name had already spread to 237 repositories through AI-generated coding-agent instructions, copied and forked without anyone checking whether the package was real, and kept receiving live install attempts from agents even after the researcher claimed the name defensively to keep an attacker from getting there first. Nobody planted this — one AI invented a name, and other AIs kept trying to install it.
Source: Aikido Security, "Slopsquatting: The AI Package Hallucination Attack Already Happening," aikido.dev/blog.
Worth noting separately, so the two don't get conflated: a different September 2025 incident, a self-replicating worm named **Shai-Hulud**, compromised hundreds of real npm packages by phishing a maintainer's credentials — not by inventing a name. Different mechanism, same lesson: something already in your dependency tree can turn hostile without anyone choosing anything.
Source: Unit 42 (Palo Alto Networks), "'Shai-Hulud' Worm Compromises npm Ecosystem in Supply Chain Attack," unit42.paloaltonetworks.com.
03 — What does good look like?
You don't need to read a line of code to check most of this. Look for:
- **Direct dependencies you can actually name** — not "ask the agent, it knows," but a list that exists somewhere and that you, or your agent on your behalf, can point to.
- **A lockfile committed alongside the code** — `package-lock.json`, `pnpm-lock.yaml`, `yarn.lock` or the equivalent — records the resolved dependency versions so installs are much more reproducible across machines and deployments.
- **A rough sense of whether each direct package is still alive** — who maintains it, and roughly when it was last released. Ingredients age like milk, not like salt: a package nobody has touched in years isn't automatically broken, but it's also not getting security fixes if something is found wrong with it.
- **The OWASP A03:2025 framing in mind, not as jargon** — "dependency policy unclear" isn't a pedantic finding. It's naming an OWASP Top 10 category of real breaches.
Sources: npm Docs — package-locks, on what a lockfile actually pins; Snyk — managing open source dependencies, on treating dependencies as an ongoing responsibility rather than a one-time choice.
None of this requires becoming the person who reviews every package by hand. It requires knowing the list exists, and asking the two or three questions above about what's on it — which is exactly what the prompt below does for you.
04 — What can you safely ask your AI agent?
You don't need to inspect any of this yourself. Ask your AI coding tool to check it for you — and don't let it guess. A search that can't verify something is not the same claim as a package that's confirmed clean; if your agent can't check a given package against real registry data, the honest answer is "I couldn't verify this," not a guess dressed up as an answer. Paste this in as-is:
The prompt to paste into your AI tool
> List this project's direct dependencies. For each, show any known security advisory and the latest release date that you can verify from available package-manager or registry data, and cite the source. If you can't verify something, say so — don't guess. Do not update anything.
Read what comes back before you act on any of it. A list of named direct dependencies, each with a verifiable last-release date and a clear "no advisory found" or "couldn't verify" next to it, is what good looks like from section 3, confirmed. A vague summary, or an agent that quietly updates something while it's "just checking," is your actual starting point — worth understanding before you build another week on top of it.
This is one article in the Launch Readiness KB series that walks through what a Trust Report scan actually looks for before you launch, hire, or raise on an AI-built app — one concept per article, always ending in something safe to ask your agent, never something that changes your code.
---
# https://mikbry.com/blog/kb/dependencies-fr/
# Ton agent IA a installé des dizaines de paquets que tu n'as jamais choisis. Faut-il s'en inquiéter ?
Mik Bry · 2026-08-25 · lecture ~9 min · KB · Prêt à lancer

Quand ton outil d'IA ajoute une connexion, un export PDF ou un paiement, il ne réécrit généralement pas tout depuis zéro. Il s'appuie sur des paquets déjà publiés par d'autres développeurs. Ce sont des dépendances. Ça peut vite représenter des dizaines de paquets directs, et bien plus de transitifs.
Cela, en soi, n'a rien d'inhabituel — la plupart des applications modernes reposent largement sur des paquets tiers, qu'elles soient développées par un humain ou avec un agent IA. Un développeur peut s'arrêter pour regarder qui maintient un paquet, s'il est encore actif ou largement utilisé. Avec un agent, ce choix peut se faire au fil de la tâche sans qu'il y ait de revue explicite. C'est ce que veut dire « non revu » ici : pas que le code soit mauvais, mais que personne n'a jamais tranché la question.
Ce que couvre cet article
1. [C'est quoi, concrètement ?](#s1)
2. [Pourquoi s'en soucier si tu ne codes pas ?](#s2)
3. [À quoi ressemble un projet bien structuré ?](#s3)
4. [Que peux-tu demander sans risque à ton agent IA ?](#s4)
01 — C'est quoi, concrètement ?
Imagine les dépendances de ton app comme des ingrédients qu'on achète, pas qu'on cultive. Une cuisine de restaurant ne cultive pas sa propre farine — elle commande à des fournisseurs de confiance, et une bonne cuisine vérifie quand même la livraison avant que ça n'atterrisse dans un plat. Ton app fonctionne pareil : du code que tu n'as pas écrit n'est pas automatiquement du code utilisable sans vérifier.
Il faut distinguer deux niveaux, dont le second reste souvent invisible pour un non-développeur. Les **dépendances directes** sont les paquets que ton agent a explicitement ajoutés. Les **dépendances transitives** sont tout ce dont ces paquets ont besoin à leur tour, installé automatiquement, parfois sur plusieurs niveaux, sans que personne ne l'ait choisi. Vingt dépendances directes peuvent facilement en porter plusieurs centaines de transitives en dessous — invisibles tant que personne n'est allé regarder.
Dans les deux cas, il peut ne jamais y avoir de moment où quelqu'un s'arrête pour vérifier le choix. C'est exactement l'écart dont parle cet article.
02 — Pourquoi s'en soucier si tu ne codes pas ?
Parce que c'est une catégorie reconnue de défaillance réelle, pas une préoccupation marginale. L'[édition 2025 de l'OWASP Top 10](https://owasp.org/Top10/) — la liste la plus partagée des façons dont les applications se font compromettre — a renommé et élargi une catégorie de 2021 (« Composants vulnérables et obsolètes »). **A03:2025 Software Supply Chain Failures fait partie des catégories de l'OWASP Top 10.** Le nom de 2021 ne mérite d'être connu qu'à titre historique.
Source : OWASP Top 10:2025, catégorie A03 — Software Supply Chain Failures, owasp.org/Top10. Citée ici comme le cadre actuel ; A06:2021 Vulnerable and Outdated Components en est le prédécesseur historique, pas une catégorie distincte encore d'actualité.
Il existe aussi un risque propre à l'IA, qui n'existait pas avant que des agents n'écrivent eux-mêmes des commandes d'installation : le **slopsquatting**. Un modèle d'IA suggère parfois avec assurance un nom de paquet qui sonne juste et qui n'existe pas — le nom est plausible, pas réel. Si un attaquant remarque quels noms inventés les modèles suggèrent régulièrement et les enregistre le premier, le prochain agent qui installe ce paquet en croyant bien faire récupère ce que l'attaquant y a mis.
Ce n'est pas hypothétique. En janvier 2026, un chercheur chez Aikido a trouvé un paquet nommé `react-codeshift` — un nom inventé par une IA fusionnant deux paquets réels sans rapport (`jscodeshift` et `react-codemod`), qui n'existait pas encore dans le registre npm. Déjà propagé à 237 dépôts via des instructions pour agents de code générées par IA, copiées sans vérifier si le paquet était réel, il continuait de recevoir de vraies tentatives d'installation même après que le chercheur l'ait enregistré lui-même pour empêcher un attaquant de le faire. Personne n'a rien planté ici — une IA a inventé un nom, d'autres IA ont continué d'essayer de l'installer.
Source : Aikido Security, « Slopsquatting: The AI Package Hallucination Attack Already Happening », aikido.dev/blog.
À noter séparément, pour ne pas confondre les deux : un autre incident de septembre 2025, un ver auto-propageant nommé **Shai-Hulud**, a compromis des centaines de vrais paquets npm en piégeant par phishing les identifiants d'un mainteneur — pas en inventant un nom. Mécanisme différent, même leçon : une dépendance déjà présente dans ton projet peut devenir dangereuse sans qu'aucun nouveau choix explicite ne soit fait.
Source : Unit 42 (Palo Alto Networks), « "Shai-Hulud" Worm Compromises npm Ecosystem in Supply Chain Attack », unit42.paloaltonetworks.com/fr.
03 — À quoi ressemble un projet bien structuré ?
Pas besoin de lire du code pour vérifier l'essentiel. Cherche :
- **Des dépendances directes que tu peux nommer** — pas « demande à l'agent, il sait », mais une liste qui existe quelque part.
- **Un lockfile commité avec le code** — `package-lock.json`, `pnpm-lock.yaml`, `yarn.lock` ou l'équivalent — enregistre les versions résolues des dépendances, ce qui rend les installations beaucoup plus reproductibles d'une machine ou d'un déploiement à l'autre.
- **Une idée, même approximative, de l'état de chaque dépendance directe** — qui la maintient et quand elle a été mise à jour pour la dernière fois. Les ingrédients vieillissent comme du lait, pas comme du sel : un paquet délaissé depuis des années n'est pas automatiquement cassé, mais il ne reçoit pas non plus de correctif si un problème y est découvert.
- **Le cadre OWASP A03:2025 en tête, pas comme du jargon** — « politique de dépendances floue » n'est pas un constat pointilleux. Ça nomme une catégorie de l'OWASP Top 10, pas un détail.
Sources : npm Docs — package-locks, sur ce qu'un lockfile fige réellement ; Snyk — gérer les dépendances open source, sur le fait de traiter les dépendances comme une responsabilité continue plutôt qu'un choix ponctuel.
Rien de tout ça ne demande de revoir chaque paquet à la main. Ça demande de savoir que la liste existe, et de poser ces deux ou trois questions — exactement ce que fait le prompt ci-dessous.
04 — Que peux-tu demander sans risque à ton agent IA ?
Tu n'as besoin de vérifier aucun de ces points toi-même. Demande à ton outil d'IA de le faire pour toi — et ne le laisse pas deviner. Une recherche qui ne peut rien vérifier n'affirme pas la même chose qu'un paquet confirmé sain ; si ton agent ne peut pas vérifier un paquet à partir de données fiables du registre, la réponse honnête est « je n'ai pas pu le vérifier », pas une supposition déguisée. Copie-colle ce prompt tel quel :
Le prompt à coller dans ton outil d'IA
> Liste les dépendances directes de ce projet. Pour chacune, montre toute alerte de sécurité connue et la date de dernière publication que tu peux vérifier à partir des données de gestionnaire de paquets ou de registre disponibles, et cite la source. Si tu ne peux pas vérifier quelque chose, dis-le — ne devine pas. Ne mets rien à jour.
Lis la réponse avant d'agir dessus. Une liste de dépendances nommées, chacune avec une date de dernière publication vérifiable et un « aucune alerte trouvée » ou « impossible à vérifier » clair, ça correspond aux signaux recherchés dans la section 3. Un résumé vague, ou un agent qui met discrètement quelque chose à jour pendant qu'il « vérifie juste », c'est ton vrai point de départ — à comprendre avant de construire une semaine de plus dessus.
Cet article fait partie de la série Launch Readiness KB : un concept à la fois pour comprendre ce que le Trust Report vérifie avant de lancer ton app, d'embaucher ou de lever des fonds. Chaque article se termine par quelque chose que tu peux demander à ton agent sans modifier le code.
---
# https://mikbry.com/blog/kb/external-services-and-monitoring/
# What happens when Stripe, email, or your AI API goes down?
Your app almost certainly doesn't do everything itself. Something else takes the payment. Something else sends the confirmation email. Something else checks the password, or answers the AI prompt. Your agent may have wired several of these in while building, sometimes without making the dependency particularly visible to you. Most non-technical founders I talk to can't actually name them.
That's fine, most of the time. It stops being fine the moment one of those services is slow, returns an error, or goes offline, and your app has to decide what to show a real person in that moment. I often find that the failure behavior hasn't really been decided yet. The app just hasn't hit that moment yet.
What this article covers
1. [What is it?](#s1)
2. [Why should you care if you don't code?](#s2)
3. [What does good look like?](#s3)
4. [What can you safely ask your AI agent?](#s4)
01 — What is it?
An external service is anything your app asks another company's computer to do for it. The clearest way I've found to explain what that request actually is: think of your app as a customer at a restaurant, and the external service as the kitchen. Your app doesn't cook the meal — it hands a waiter (the API) an order, the waiter carries it to a kitchen it doesn't control, and eventually a plate comes back, or doesn't.
Four kinds of external service show up very often in AI-built apps:
- **Payments** — usually Stripe, sometimes Paddle or a similar processor. It moves the money and tells your app what happened.
- **Email** — a sending service like Postmark, Resend, or SendGrid. It delivers the confirmation, the receipt, the password reset.
- **Auth** — a login provider, or a chunk of it, handling passwords, sessions, or "sign in with Google."
- **AI** — the model API your product itself calls, separate from the AI tool you used to build the app.
You don't need to understand how any of these are wired in. You need to know that they exist, and that a waiter can drop a plate, get the order wrong, or bring one twice.
02 — Why should you care if you don't code?
Because when the kitchen is closed, your user doesn't blame the kitchen. They blame the restaurant. Stripe having a bad ten minutes, or your email provider silently rate-limiting you, isn't a fault in your app in any sense that matters to the person hitting "pay now." **It's not your fault, and it's still your problem** — the failure surfaces as your product being broken, on your watch, in front of your customer.
The sharpest version of this, and the one an AI-built app is least likely to be guarding against, isn't "the payment failed." It's **the payment succeeding while your app thinks it failed.**
Here's how that happens. Stripe doesn't just take the payment — it separately sends your app a notification (a "webhook") confirming the charge went through, and your app is usually the thing that updates its own records off that notification, not off the payment itself. If that notification is lost or delayed, the two records can disagree: Stripe has the money, your app still shows the order as failed. If the app handles a duplicate event incorrectly, it may process the same successful payment twice internally.
Source: Stripe's own webhook documentation covers exactly this — duplicate events and delivery retries are expected behavior, not an edge case (Stripe — handling duplicate webhook events).
An agent building toward "the happy path works" has no particular reason to think about the notification failing separately from the payment failing — they feel like the same event from inside a chat window where everything looks like it worked. They aren't the same event, and the gap between them is exactly where a customer ends up charged with no order, or worse.
03 — What does good look like?
Not a circuit breaker. Not a retry queue. Good, at this stage, is much smaller: **for every external service your app calls, there's an answer you or your agent can actually state out loud for "what happens if this one fails right now."** Even if the honest answer is "nothing — it just breaks and the user sees an error," that's a real answer you can act on. "I don't know" is the only wrong one.
A useful shape for that answer is *degraded, not dead*. Chrome's own offline page still lets you play a small dinosaur game instead of showing a blank error — the browser stayed useful even though the network didn't. Checking email in airplane mode works the same way: your mail app shows you the last inbox it synced and queues anything you draft, rather than pretending you have no email at all. Neither example hides the failure. Both keep the person in front of the screen doing something sensible instead of staring at a dead end.
Monitoring is the other half. A pattern I still see is that the first alert is an unhappy customer email. Nothing was watching production, so nothing told you first. The fix for that isn't a full observability stack — you don't need to evaluate Sentry versus Datadog versus Better Stack before you launch. The floor is much lower: **one alert, to your inbox, when something breaks in production.** Think of it as a check-engine light, not a mechanic's full diagnostic bay — or a flight data recorder, a diary the app keeps of what went wrong and when, so "it broke" has a timestamp and a cause instead of just a customer's memory of "it didn't work yesterday."
One more thing worth checking, separate from whether monitoring exists at all: an agent can add a monitoring line of code once and never confirm it actually fires. A tool being installed and a tool being configured to reach you are two different claims — verifying the second one is part of clearing this floor, not an optional extra.
04 — What can you safely ask your AI agent?
These are two different diagnostic questions, on purpose, and I'd rather you run them separately than collapse them into one. The first is about what your app *does* when something it depends on fails. The second is about whether anyone would *find out*. An agent can answer either one honestly without touching a single line of code — and a search that comes back empty is not the same claim as "there's nothing there." If your agent can't find a fallback, or can't find any monitoring, the honest answer is "I couldn't find one," never "there is none."
Prompt 1 — what happens when a service fails
> List every external service this app calls (payments, email, auth, AI). For each, show what the app does if it times out or returns an error — or tell me you couldn't find any handling for that case. Don't change anything.
Read what comes back before you touch prompt two. A short list with a stated behavior next to each entry — even an honest "no handling found" — is exactly what section 3 describes as a real answer.
Prompt 2 — whether you'd find out
> Is there any error monitoring or logging that would alert me when something breaks in production? Show me where it's configured, or tell me you couldn't find any — don't assume production is monitored. Don't add anything yet.
Read both answers, don't act on either yet. Together they tell you where you actually stand — not what "should" be there, what's really there — and that's the honest starting point for deciding what, if anything, needs to change before you launch.
This is one article in the Launch Readiness KB series — it walks through what a Trust Report scan actually looks for before you launch, hire, or raise on an AI-built app, one concept per article, always ending in something safe to ask your agent, never something that changes your code.
---
# https://mikbry.com/blog/kb/external-services-and-monitoring-fr/
# Que se passe-t-il quand Stripe, ton email ou ton API IA tombe en panne ?
Mik Bry · 2026-08-25 · lecture ~9 min · KB · Prêt à lancer

Ton app ne fait sans doute pas tout elle-même. Quelque chose d'autre encaisse le paiement. Quelque chose d'autre envoie l'email de confirmation. Quelque chose d'autre vérifie le mot de passe, ou répond au prompt IA. Ton agent a peut-être branché plusieurs de ces services en cours de route, sans que tu voies toujours à quel point ton app en dépend. La plupart des fondateurs non-tech à qui je parle sont incapables de les nommer.
La plupart du temps, c'est sans conséquence. Ça cesse de l'être dès qu'un service ralentit, renvoie une erreur ou tombe en panne, et que ton app doit décider ce qu'elle montre à une vraie personne, à ce moment précis. Je vois souvent que personne n'a vraiment décidé comment l'app doit se comporter en cas de panne. Elle n'est simplement pas encore tombée sur ce cas-là.
Ce que couvre cet article
1. [C'est quoi, concrètement ?](#s1)
2. [Pourquoi s'en soucier si tu ne codes pas ?](#s2)
3. [À quoi ressemble un projet bien structuré ?](#s3)
4. [Que peux-tu demander sans risque à ton agent IA ?](#s4)
01 — C'est quoi, concrètement ?
Un service externe, c'est tout ce que ton app demande à l'ordinateur d'une autre entreprise de faire à sa place. Voici l'image la plus claire que j'aie trouvée : imagine ton app comme un client au restaurant, et le service externe comme la cuisine. Ton app ne cuisine pas le plat elle-même — elle confie une commande à un serveur (l'API), le serveur porte la commande vers une cuisine qu'elle ne contrôle pas, et une assiette finit par revenir, ou pas.
Quatre types de services reviennent très souvent :
- **Le paiement** — souvent Stripe, parfois Paddle ou un processeur équivalent. Il traite le paiement et indique à ton app ce qui s'est passé.
- **L'email** — un service d'envoi comme Postmark, Resend ou SendGrid. Il livre la confirmation, le reçu, la réinitialisation de mot de passe.
- **L'authentification** — un fournisseur de connexion, ou un bout de cette brique, qui gère les mots de passe, les sessions, ou le « se connecter avec Google ».
- **L'IA** — l'API du modèle que ton produit appelle lui-même, à distinguer de l'outil d'IA que tu as utilisé pour construire l'app.
Tu n'as pas besoin de comprendre comment chacun est branché. Tu as besoin de savoir qu'ils existent, et qu'un serveur peut faire tomber une assiette, se tromper de commande, ou en apporter deux fois.
02 — Pourquoi s'en soucier si tu ne codes pas ?
Parce que quand la cuisine est fermée, ton utilisateur ne s'en prend pas à la cuisine. Il s'en prend au restaurant. Peu importe que le problème vienne de Stripe plutôt que de ton code : pour la personne qui clique sur « payer maintenant », c'est ton produit qui ne marche pas. **Ce n'est pas de ta faute, et ça reste ton problème** — devant ton client, c'est ton produit qu'on regarde, pas Stripe.
Le cas le plus piégeux — celui que ton app a le moins de chances de voir venir — ce n'est pas « le paiement a échoué ». C'est **le paiement qui réussit alors que ton app pense qu'il a échoué.**
Voici comment ça arrive. Stripe n'encaisse pas seulement le paiement — il envoie séparément à ton app une notification (un « webhook ») confirmant que la transaction est passée, et c'est généralement cette notification, pas le paiement lui-même, que ton app utilise pour mettre à jour ses propres données. Si cette notification est perdue ou retardée, les deux versions peuvent se contredire : Stripe a l'argent, ton app affiche toujours la commande en échec. Si l'app gère mal un événement dupliqué, elle peut traiter deux fois en interne le même paiement pourtant réussi.
Source : la documentation de Stripe sur les webhooks couvre exactement ce cas — les événements dupliqués et les tentatives de livraison répétées sont un comportement attendu, pas un cas limite (Stripe — gérer les événements de webhook dupliqués).
Un agent qui vise surtout à faire marcher le chemin nominal n'a aucune raison de distinguer l'échec de la notification de celui du paiement : depuis la conversation avec ton agent où tout semble avoir marché, les deux se confondent. Ce ne sont pourtant pas le même événement, et c'est exactement dans cet écart qu'un client finit facturé sans commande, ou pire.
03 — À quoi ressemble un projet bien structuré ?
Pas besoin, à ce stade, de mise en place technique compliquée pour gérer les pannes. Un projet bien structuré, c'est beaucoup plus modeste : **pour chaque service externe que ton app appelle, toi ou ton agent devez pouvoir répondre à voix haute à cette question : « que se passe-t-il si celui-ci tombe en panne maintenant ? »** Même si la réponse honnête est « rien — ça casse et l'utilisateur voit une erreur », c'est une vraie réponse, sur laquelle tu peux agir. « Je ne sais pas » est la seule mauvaise réponse.
Une forme utile pour cette réponse : continuer à fonctionner, même en mode dégradé. La page hors-ligne de Chrome te laisse quand même jouer au petit jeu du dinosaure au lieu d'afficher une erreur vide — le navigateur reste utile même quand le réseau ne l'est plus. Consulter ses emails en mode avion fonctionne pareil : ton client mail affiche la dernière boîte de réception synchronisée et met en file d'attente ce que tu rédiges, plutôt que de prétendre que tu n'as aucun email. Aucun des deux exemples ne cache la panne. Les deux laissent la personne devant l'écran faire quelque chose de sensé, plutôt que de fixer une impasse.
Le monitoring, c'est l'autre moitié. Un cas que je rencontre encore souvent : la première alerte vient d'un email de client mécontent. Rien ne surveillait la production. La solution n'est pas une pile d'observabilité complète — pas besoin de comparer Sentry, Datadog et Better Stack avant de lancer. Le minimum est beaucoup plus simple : **une seule alerte, dans ta boîte mail, quand quelque chose casse en production.** Vois ça comme un voyant moteur, pas un diagnostic complet chez un garagiste — ou comme une boîte noire d'avion, un journal de ce qui a mal tourné et quand, pour que « ça a cassé » ait un horodatage et une cause plutôt que le seul souvenir d'un client mécontent.
Source : la distinction pratique entre le logging (l'enregistrement) et l'alerting (ce qui te prévient réellement) est bien posée dans le guide de Better Stack, en anglais (Better Stack — observability vs. monitoring) ; les recommandations d'OWASP restent la référence de base, en anglais également, pour savoir quoi journaliser et comment gérer les erreurs sans risque (OWASP — Logging Cheat Sheet, OWASP — Error Handling Cheat Sheet).
Une dernière chose à vérifier : un agent peut ajouter un outil de monitoring sans jamais confirmer qu'il se déclenche vraiment. L'installer et le configurer pour te joindre, ce n'est pas pareil — vérifier ce second point fait partie du minimum.
04 — Que peux-tu demander sans risque à ton agent IA ?
Ce sont volontairement deux questions de diagnostic différentes, et je préfère que tu les poses séparément plutôt que de les fondre en une seule. La première porte sur ce que ton app *fait* quand quelque chose dont elle dépend tombe en panne. La seconde porte sur autre chose : est-ce que quelqu'un *le saurait* ? Un agent peut répondre honnêtement à chacune sans toucher une seule ligne de code — et une recherche qui ne trouve rien n'affirme pas la même chose que « il n'y a rien ici ». Si ton agent ne trouve pas de solution de repli, ou pas de monitoring, la réponse honnête est « je n'en ai pas trouvé », jamais « il n'y en a pas ».
Prompt 1 — ce qui se passe quand un service tombe en panne
> Liste tous les services externes que cette app appelle (paiement, email, authentification, IA). Pour chacun, montre-moi ce que fait l'app si le service ne répond pas à temps ou renvoie une erreur — ou dis-moi que tu n'as trouvé aucune gestion pour ce cas. Ne change rien.
Lis la réponse avant de passer au deuxième prompt. Une courte liste, avec pour chaque entrée un comportement clairement énoncé — même un honnête « aucune gestion trouvée » — c'est exactement ce que la section 3 appelle une vraie réponse.
Prompt 2 — si tu le saurais
> Y a-t-il un monitoring d'erreurs ou du logging qui m'alerterait si quelque chose casse en production ? Montre-moi où c'est configuré, ou dis-moi que tu n'en as trouvé aucun — ne suppose pas que la production est surveillée. N'ajoute rien pour l'instant.
Lis les deux réponses, n'agis sur aucune tout de suite. Ensemble, elles te disent où tu en es vraiment, pas ce qui « devrait » être là — et c'est le point de départ honnête avant de décider ce qui doit changer.
Cet article fait partie de la série Launch Readiness KB : un concept à la fois pour comprendre ce que le Trust Report vérifie avant de lancer ton app, d'embaucher ou de lever des fonds. Chaque article se termine par quelque chose que tu peux demander à ton agent sans modifier le code.
---
# https://mikbry.com/blog/kb/git-and-code-history/
# Your AI agent keeps mentioning Git. Do you need to care?
Your AI coding tool mentions "commits," "branches," or "pushing to GitHub" the way a contractor mentions rebar — like you're supposed to already know why it matters. You don't write code, so it's tempting to wave it off as plumbing you'll never need to look at.
I don't think you can afford to wave this one off, and it's the first thing I check when I look at an AI-built app for someone: does this project even have a real history. Not because you need to learn to "do" Git. Because without it, getting cleanly back to a previous working version becomes much harder.
What this article covers
1. [What is it?](#s1)
2. [Why should you care if you don't code?](#s2)
3. [What does good look like?](#s3)
4. [What can you safely ask your AI agent?](#s4)
01 — What is it?
Here's the simplest frame I've found: it's Google Docs' version history, for your entire app.
You already know that feeling — you open a Google Doc, click "version history" in the corner, and scroll back through every draft since the file was created. Google Docs saves versions automatically. Git gives software projects the same kind of history, but that history is created when changes are committed.
That happens locally: every time your AI agent (or a human developer) commits a meaningful chunk of work, Git records a snapshot — what changed, when, and a short note about why. Over weeks of building, that turns into a full timeline of your app, not just its current state.
GitHub is a different thing, and this is the part worth getting exactly right: **Git remembers the history. GitHub stores and shares that Git history online.** If Git is Word's track-changes, running on whatever machine your agent works on, GitHub is Google Drive — the place that same tracked document lives so it can be reached from anywhere, shared with someone else, and survives even if the original machine doesn't. GitHub itself isn't the version history. It's where the version history goes to be safe and shareable.
Neither of these requires you to open a terminal. Everything in this article works through [GitHub Desktop](https://docs.github.com/en/desktop/overview/getting-started-with-github-desktop) or your AI tool's own built-in GitHub integration — a few clicks, no commands to memorize.
02 — Why should you care if you don't code?
An autonomous coding agent may make changes you didn't explicitly ask for, or changes whose consequences you only notice later. That's not a flaw in any particular tool — it's what "autonomous" means. A version history is the safety net underneath that: the thing that turns "the agent broke something and I don't know what" into "here's exactly what changed, and here's the version from before it happened."
This is one of the first things I look for in a Trust Report, because so many other questions become easier once there is a reliable history. Everything else — whether tests exist, whether anything checks a change before it ships, whether secrets are exposed — is easier to reason about once you know there's a record to check against. Without version history, a scan (or a person) can't even establish what changed between "it worked yesterday" and "it doesn't today." With it, that question has an actual answer.
There's a second reason, more about ownership than safety: at some point you'll likely hand this project to a developer, bring on a co-founder, or show it to an investor. If the only copy of your app's history lives inside your AI tool's own account, you don't fully control it — you're a guest in someone else's system. Keeping the GitHub repository under an account or organisation you control, before any of that happens, is my recommendation, not an industry rule everyone follows. But it's the difference between handing someone a project and handing someone a project whose source and history you actually control.
03 — What does good look like?
You don't need to read code to check most of this. Look for:
- **A repository exists at all.** Somewhere, this project is tracked by Git — not just sitting as a folder of files with no history behind it.
- **Commits are meaningful, not one giant dump.** A useful history has regular, meaningful commits over time, rather than one giant dump that hides months of work.
- **Changes in progress are isolated somehow — often with branches** — instead of every experiment going straight to the live version.
- **A remote points at GitHub** — the local history isn't just sitting on one machine; it's backed up and reachable online.
- **You or your company control the GitHub account or organisation the repository lives under** — not an account that belongs to your AI tool, an old contractor, or nobody in particular.
If you don't have a GitHub account or a repository yet, both take a few minutes and no command line: [getting started with your GitHub account](https://docs.github.com/en/get-started/onboarding/getting-started-with-your-github-account) covers signing up, and the [quickstart for repositories](https://docs.github.com/en/repositories/creating-and-managing-repositories/quickstart-for-repositories) walks through creating one. From there, GitHub Desktop — or your AI tool's own "connect to GitHub" button — handles the rest.
Reference: freeCodeCamp's description of Git as "the Google Doc of coding" is where I first saw this analogy land cleanly for a non-technical reader, and it's the one I've kept coming back to since.
04 — What can you safely ask your AI agent?
You don't need to inspect any of this yourself. You can ask your AI coding tool to check it for you — and the exact wording matters, because a search that finds nothing is not the same claim as a project that has nothing. If your agent can't find a repository, the honest answer is "I couldn't find one," not "there is none." Paste this in as-is:
The prompt to paste into your AI tool
> Show me whether this project is inside a Git repository. If it is, show the repository root, current branch, recent commits, tags, and remotes. If you can't find one, say you couldn't find one — do not conclude that none exists. Then explain how the last known working version could be restored. Do not checkout, reset, revert, or change anything.
Read the answer, don't act on it yet. If your agent finds a real repository, recent commits, and a remote pointing to GitHub, you've found the main signals described in section 3. If it comes back saying it found nothing, that's your actual starting point — worth understanding before you build another week on top of it.
This is one article in the Launch Readiness KB series, which walks through what a Trust Report scan actually looks for before you launch, hire, or raise on an AI-built app — one concept per article, always ending in something safe to ask your agent, never something that changes your code.
---
# https://mikbry.com/blog/kb/git-and-code-history-fr/
# Ton IA n'arrête pas de parler de Git. Faut-il s'en soucier ?
Mik Bry · 2026-08-25 · lecture ~8 min · KB · Prêt à lancer

Ton outil d'IA parle de « commits », de « branches » ou de « push vers GitHub » comme si tout ça allait de soi.
Tu ne codes pas, donc tu peux facilement ranger ça dans la catégorie « technique que je n'ai pas besoin de comprendre ».
Je ne pense pas que tu puisses te permettre d'ignorer ce sujet. C'est la première chose que je regarde quand j'examine une app construite par IA pour quelqu'un : est-ce que ce projet garde un historique de ses changements. Pas pour que tu apprennes à « faire » du Git. Parce que sans ça, revenir proprement à une version précédente devient beaucoup plus difficile si ton agent IA fait un changement que tu n'avais pas demandé.
Ce que couvre cet article
1. [C'est quoi, concrètement ?](#s1)
2. [Pourquoi s'en soucier si tu ne codes pas ?](#s2)
3. [À quoi ressemble un projet bien structuré ?](#s3)
4. [Que peux-tu demander sans risque à ton agent IA ?](#s4)
01 — C'est quoi, concrètement ?
Voici l'image la plus simple que j'aie trouvée : c'est l'historique des versions de Google Docs, appliqué à toute ton application.
Tu connais probablement déjà le principe : tu ouvres un Google Doc, tu cliques sur « historique des versions » dans un coin, et tu remontes tous les brouillons depuis la création du fichier. Google Docs enregistre les versions automatiquement. Git permet d'obtenir le même type d'historique pour un logiciel, mais cet historique se construit quand les changements sont enregistrés dans des commits.
Ça se passe en local : à chaque fois que ton agent IA (ou un développeur humain) commite un morceau de travail significatif, Git en garde une photo — ce qui a changé, quand, et une courte note expliquant pourquoi. Au bout de quelques semaines de développement, ça devient une vraie chronologie de ton app, pas juste son état actuel.
GitHub, c'est autre chose, et c'est le point à ne pas confondre : **Git garde en mémoire l'historique. GitHub héberge et partage ce dépôt Git en ligne.** Si Git est le suivi des modifications de Word, qui tourne sur la machine où travaille ton agent, GitHub est Google Drive — l'endroit où ce même document suivi est hébergé pour être accessible de partout, partagé avec quelqu'un d'autre, et pour survivre même si la machine d'origine disparaît. GitHub n'est pas lui-même l'historique de versions. C'est l'endroit où cet historique va se mettre à l'abri et devenir partageable.
Rien de tout ça ne demande d'ouvrir un terminal. Tout ce qui suit fonctionne via [GitHub Desktop](https://docs.github.com/fr/desktop/overview/getting-started-with-github-desktop) ou l'intégration GitHub intégrée à ton outil d'IA — quelques clics, aucune commande à retenir.
02 — Pourquoi s'en soucier si tu ne codes pas ?
Un agent de code autonome peut faire des changements que tu n'as pas explicitement demandés, ou dont tu ne remarqueras les conséquences que plus tard. Un historique de versions sert alors de filet de sécurité : il transforme « l'agent a cassé quelque chose et je ne sais pas quoi » en « voici ce qui a changé, et voici la version précédente ».
C'est l'une des premières choses que je regarde dans un Trust Report, parce que beaucoup d'autres questions deviennent plus simples dès qu'un historique fiable existe. Tout le reste — l'existence de tests, le fait qu'une vérification tourne avant qu'un changement parte en prod, l'exposition de secrets — se raisonne plus facilement une fois qu'on sait qu'il existe un historique auquel se comparer. Sans lui, un scan (ou une personne) ne peut même pas établir ce qui a changé entre « ça marchait hier » et « ça ne marche plus aujourd'hui ». Avec lui, cette question a une vraie réponse.
Il y a une deuxième raison, plus liée à la propriété qu'à la sécurité : à un moment donné, tu vas probablement confier ce projet à un développeur, prendre un associé technique, ou le montrer à un investisseur. Si la seule copie de l'historique de ton app vit dans le compte de ton outil d'IA, tu ne le contrôles pas vraiment — tu es invité dans le système de quelqu'un d'autre. Avoir le dépôt GitHub dans un compte ou une organisation que tu contrôles, avant que tout ça n'arrive, c'est ma recommandation, pas une règle du secteur que tout le monde suit. Mais c'est la différence entre confier un projet et confier un projet dont tu contrôles réellement le code source et l'historique.
03 — À quoi ressemble un projet bien structuré ?
Pas besoin de savoir lire du code pour vérifier l'essentiel. Cherche :
- **Un dépôt existe, tout simplement.** Quelque part, ce projet est suivi par Git — pas juste un dossier de fichiers sans historique derrière.
- **Les commits sont significatifs, pas un seul gros paquet.** Un historique utile contient des commits réguliers et compréhensibles dans le temps, plutôt qu'un seul énorme commit qui masque des mois de travail.
- **Les changements en cours sont isolés d'une manière ou d'une autre — souvent avec des branches** — au lieu d'envoyer chaque expérimentation directement vers la version en production.
- **Un dépôt distant (« remote ») pointe vers GitHub** — l'historique local ne reste pas coincé sur une seule machine ; il est sauvegardé et accessible en ligne.
- **Toi (ou ton entreprise) contrôles le compte GitHub ou l'organisation sous lequel vit le dépôt** — pas un compte qui appartient à ton outil d'IA, à un ancien prestataire, ou à personne en particulier.
Si tu n'as pas encore de compte GitHub ou de dépôt, les deux prennent quelques minutes, sans ligne de commande : [créer ton compte GitHub](https://docs.github.com/fr/get-started/onboarding/getting-started-with-your-github-account) explique l'inscription, et le [guide de démarrage rapide pour créer un dépôt](https://docs.github.com/fr/repositories/creating-and-managing-repositories/quickstart-for-repositories) te guide pour en créer un. Ensuite, GitHub Desktop — ou le bouton « connecter à GitHub » intégré à ton outil d'IA — fait le reste.
Référence : l'expression « le Google Doc du code » utilisée par freeCodeCamp pour décrire Git est la première fois que j'ai vu cette analogie tenir la route pour un lecteur non-technique, et c'est celle à laquelle je reviens depuis.
04 — Que peux-tu demander sans risque à ton agent IA ?
Tu n'as besoin de vérifier aucun de ces points toi-même. Tu peux demander à ton outil d'IA de le faire pour toi — et la formulation exacte compte, parce que ne pas trouver de dépôt ne prouve pas qu'il n'existe pas. Si ton agent ne trouve pas de dépôt, la réponse honnête est « je n'en ai pas trouvé », pas « il n'y en a pas ». Copie-colle ce prompt tel quel :
Le prompt à coller dans ton outil d'IA
> Montre-moi si ce projet se trouve dans un dépôt Git. Si oui, montre la racine du dépôt, la branche actuelle, les commits récents, les tags et les remotes. Si tu n'en trouves pas, dis-moi simplement que tu n'en as pas trouvé — ne conclus pas qu'il n'y en a pas. Ensuite, explique-moi comment la dernière version fonctionnelle connue pourrait être restaurée. Ne fais aucun checkout, reset, revert, ni aucune modification.
Lis la réponse, n'agis pas encore dessus. Si ton agent trouve un vrai dépôt, des commits récents et un dépôt distant qui pointe vers GitHub, tu retrouves les principaux signaux décrits dans la section 3. S'il te répond qu'il n'a rien trouvé, c'est ton vrai point de départ — à comprendre avant de construire une semaine de plus dessus.
Cet article fait partie de la série Launch Readiness KB : un concept à la fois pour comprendre ce que le Trust Report vérifie avant de lancer ton app, d'embaucher ou de lever des fonds. Chaque article se termine par quelque chose que tu peux demander à ton agent sans modifier le code.
---
# https://mikbry.com/blog/kb/project-continuity/
# The successor test: could another developer take over your app tomorrow?
Here's a question worth asking yourself today, before anything goes wrong: if you hired a developer tomorrow, could they open your project and actually pick it up — or would the first thing they tell you be "give me a week to read through this before I can quote you anything"?
That gap between those two answers is real money and real time, and it exists whether or not you ever change developers.
In this article
1. [What is it?](#s1)
2. [Why should a non-developer care?](#s2)
3. [What does good look like?](#s3)
4. [What can I safely ask my AI agent?](#s4)
01 — What is it?
Software teams have a name for this risk: the **bus factor** — the number of people who could disappear from a project before it's in real trouble. A project with a bus factor of one depends entirely on whichever single person currently holds the context in their head. A widely cited 2016 study of 133 popular open-source projects on GitHub found that 46% of them had a bus factor of exactly one. Those were established projects with commit histories going back years. A solo founder building primarily with AI can easily end up with a bus factor of one, without ever consciously deciding that's the risk they're taking.
I call the version worth checking today the **successor test**: could you hand this project to another developer right now and get back a meaningful, fixed-price quote — without paying them a week just to figure out what your app does and how it's built?
Existing writing about "bus factor" or "handoff" almost always assumes a human predecessor the new developer can interview. That's not your situation. If your app was built with Cursor, Claude Code, Lovable, v0, Replit or similar, a lot of the *why* behind the code — the tradeoffs you discussed, the shortcuts you agreed to take, the "we'll fix this properly later" — never made it into a comment or a commit message. That context may live in an AI conversation that isn't part of the repository or accessible to the next developer. Reconstructing a decision from an old AI chat can be harder than reconstructing it from a human's memory, because at least you can still ask a human a follow-up question.
02 — Why should a non-developer care?
You don't need to plan for disaster to care about this. The cost shows up immediately, the first time you need outside help for any reason — hiring your first developer, bringing in an agency, adding a technical co-founder, or just asking a freelancer to fix one bug while you're busy elsewhere.
Without minimal documentation, many of those conversations start with some version of: "we need time to understand the code before we can quote the work." That week is not a hypothetical future cost. It's a cost you're already carrying today. That discovery time can end up reflected in the estimates you receive.
Think of it as the recipe versus the finished dish. Your running app is the dish — it looks and tastes right, and that's genuinely worth something. But a new cook can't reproduce it, extend it, or safely change one ingredient without the recipe: what's in it, why it's built that way, what happens if you swap something out. Most founders picture handing off a project like handing over a tidy binder — a clear README, a short "here's how it works," a list of decisions and why they were made. What actually gets handed off, most of the time, is the finished dish with no recipe at all: a working app and a closed chat window.
03 — What does good look like?
You don't need professional-grade documentation to pass the successor test. You need three things, each short enough to read in one sitting, and each low enough of a bar that you — a non-coder — can ask your own AI coding tool to draft it directly from your existing project:
- **A README.** What the app does, who it's for, how to run it locally, and where the important pieces live.
- **A plain-English architecture summary.** A few paragraphs, no diagrams required: what are the main parts (the app, the database, the payment provider, the email service, whatever else it talks to), and roughly how they connect.
- **A decision log in plain language.** Not a changelog of *what* changed — a short record of *why* the consequential choices were made, the kind of thing that used to live only in your chat history.
The bar here is deliberately low. As Tom Preston-Werner put it back in 2010, arguing for writing the README before the code: software without useful documentation is nearly worthless to anyone but the person who already understands it, and writing down your intent is what makes it possible for someone else to collaborate on it at all. That was true before AI-assisted coding existed, and it hasn't stopped being true now that the first draft of your code came from a conversation instead of from you typing it line by line.
This is a look-and-report question, not a "go write the docs" instruction. You're diagnosing the gap before you decide what to do about it — the same "not found" discipline as everywhere else in this series: an agent that can't find documentation should tell you it found none, not assume it doesn't need to write more.
Ask your AI agent — read-only
*"Could another developer take over this project from the documentation alone? List the three biggest gaps. Don't write anything yet."*
Read the answer carefully. If the agent says it found no documentation at all, that finding *is* your first gap — not a sign the check failed. Sit with the list for a day before deciding what, if anything, to fix. That decision is yours; the prompt above only exists to make sure you're making it with the facts in front of you instead of finding out during an actual handoff.
This is one article in the Launch Readiness KB series. The successor test itself costs nothing and takes a few minutes — what you do with the answer is up to you, instead of a future developer's quote deciding it for you.
---
# https://mikbry.com/blog/kb/project-continuity-fr/
# Le test du successeur : un autre développeur pourrait-il reprendre ton app demain ?

Voici une question à te poser dès aujourd'hui, avant qu'il n'y ait le moindre problème : si tu embauchais un développeur demain, est-ce qu'il pourrait ouvrir ton projet et le reprendre directement — ou sa première phrase serait-elle « laisse-moi une semaine pour tout lire avant de pouvoir te chiffrer quoi que ce soit » ?
Cet écart coûte du temps et de l'argent, que tu changes un jour de développeur ou non.
Dans cet article
1. [Qu'est-ce que c'est ?](#s1)
2. [Pourquoi un non-développeur devrait s'en soucier ?](#s2)
3. [À quoi ressemble une bonne pratique ?](#s3)
4. [Que peux-tu demander à ton agent IA sans risque ?](#s4)
01 — Qu'est-ce que c'est ?
Les équipes de développement ont un nom pour ce risque : le **facteur bus** — le nombre de personnes qui pourraient disparaître d'un projet avant qu'il ne soit vraiment en danger. Un projet avec un facteur bus unitaire dépend entièrement d'une seule personne, celle qui porte actuellement tout le contexte dans sa tête. Une étude de 2016, largement citée, portant sur 133 projets open source populaires sur GitHub, a trouvé que 46 % d'entre eux dépendaient essentiellement d'une seule personne. Il s'agissait de projets établis, avec un historique de commits remontant à plusieurs années. Une personne qui construit son projet seule, principalement avec l'IA, peut facilement se retrouver avec un facteur bus unitaire — sans que ce soit jamais un choix conscient.
J'appelle ça le « test du successeur » : pourrais-tu confier ce projet à un autre développeur maintenant, et obtenir en retour un devis à prix fixe qui tienne debout — sans d'abord le payer une semaine rien que pour comprendre ce que fait ton app et comment elle est construite ?
Ce qu'on lit habituellement sur le « facteur bus » ou la « reprise de projet » suppose presque toujours un prédécesseur humain que le nouveau développeur peut interroger. Ce n'est pas ta situation. Si ton app a été construite avec Cursor, Claude Code, Lovable, v0, Replit ou un outil similaire, une bonne partie du contexte qui explique pourquoi le code est comme ça — les compromis discutés, les raccourcis acceptés, les « on corrigera ça proprement plus tard » — ne s'est jamais retrouvée dans un commentaire ou un message de commit. Ce contexte peut n'exister que dans une conversation avec ton IA — hors du dépôt, invisible pour le prochain développeur. Retrouver pourquoi une décision a été prise dans une vieille conversation avec l'IA peut être plus difficile que de le demander directement à la personne qui l'a prise.
02 — Pourquoi un non-développeur devrait s'en soucier ?
Pas besoin d'anticiper une catastrophe pour s'en soucier. Le coût apparaît immédiatement, dès la première fois où tu as besoin d'aide extérieure, pour n'importe quelle raison — embaucher ton premier développeur, faire intervenir une agence, prendre un·e associé·e technique, ou simplement demander à un·e freelance de corriger un bug pendant que tu es occupé ailleurs.
Sans documentation minimale, beaucoup de ces conversations commencent par une variante de : « il faut d'abord qu'on comprenne le code avant de pouvoir chiffrer le travail ». Ce temps de découverte peut ensuite se retrouver dans les devis que tu reçois.
Vois ça comme la recette et le plat fini. Ton app qui fonctionne, c'est le plat — il a l'air bon et il a bon goût, et ça vaut vraiment quelque chose. Mais un nouveau cuisinier ne peut pas le reproduire, l'améliorer ou changer un ingrédient en toute sécurité sans la recette : ce qu'elle contient, pourquoi elle est construite ainsi, ce qui se passe si on change un ingrédient. La plupart des porteurs de projet imaginent une reprise comme la remise d'un classeur bien rangé — un README clair, un court « voici comment ça marche », une liste des décisions et de leurs raisons. Ce qui est réellement transmis, la plupart du temps, c'est le plat fini sans aucune recette : une app qui fonctionne et une fenêtre de discussion fermée.
03 — À quoi ressemble une bonne pratique ?
Pas besoin d'une documentation professionnelle pour réussir le test du successeur. Il te faut trois choses, chacune assez courte pour se lire d'une traite, et chacune assez simple pour que tu puisses — sans écrire une ligne de code — demander à ton propre outil d'IA de la rédiger directement à partir de ton projet existant :
- **Un README.** Ce que fait l'app, à qui elle s'adresse, comment la lancer en local, et où se trouvent les éléments importants.
- **Un résumé d'architecture en langage clair.** Quelques paragraphes, aucun schéma nécessaire : quelles sont les grandes parties (l'app, la base de données, le prestataire de paiement, le service d'e-mail, et les autres services auxquels elle se connecte), et comment elles s'articulent, grosso modo.
- **Un journal de décisions en langage clair.** Pas un changelog de *ce qui* a changé — un court résumé de *pourquoi* les choix importants ont été pris, le genre de chose qui, jusque-là, ne se trouvait que dans ton historique de conversation.
Pas besoin d'aller beaucoup plus loin à ce stade. Comme l'écrivait Tom Preston-Werner en 2010, en plaidant pour écrire le README avant le code : un logiciel sans documentation utile ne vaut presque rien pour quiconque ne le comprend pas déjà, et écrire ton intention est ce qui permet à quelqu'un d'autre d'y contribuer. C'était vrai avant même l'existence du développement assisté par IA, et ça reste vrai maintenant que le premier jet de ton code vient d'une conversation plutôt que d'un clavier.
04 — Que peux-tu demander à ton agent IA sans risque ?
C'est une question de constat, pas une instruction de « va écrire la doc ». Tu diagnostiques l'écart avant de décider quoi en faire — la même discipline du « pas trouvé » que partout ailleurs dans cette série : un agent qui ne trouve pas de documentation doit dire qu'il n'en a trouvé aucune, pas supposer qu'il n'a pas besoin d'en écrire davantage.
À demander à ton agent IA — lecture seule
*« Un autre développeur pourrait-il reprendre ce projet à partir de la seule documentation ? Liste les trois lacunes les plus importantes. N'écris rien pour l'instant. »*
Lis la réponse attentivement. Si l'agent dit n'avoir trouvé aucune documentation, ce constat *est* ta première lacune — pas un signe que le test a échoué. Laisse reposer la liste un jour avant de décider quoi corriger, si tu décides de corriger quelque chose. Cette décision t'appartient ; le prompt ci-dessus est juste là pour que tu la prennes en connaissance de cause, plutôt que de tout découvrir pendant une vraie reprise.
Cet article fait partie de la série Launch Readiness KB : un concept à la fois pour comprendre ce que le Trust Report vérifie avant de lancer ton app, d'embaucher ou de lever des fonds. Chaque article se termine par quelque chose que tu peux demander à ton agent sans modifier le code.
---
# https://mikbry.com/blog/kb/secrets-and-api-keys/
# Your AI agent just wrote an API key directly into the code. Can your users see it?
Your AI coding tool needed to talk to Stripe, or OpenAI, or some other service, so it asked you to paste in an API key — and then it wired that key into the code. Reasonable enough. What's not obvious, if you don't code, is that "wired into the code" sometimes means "wired into the code your users' browsers download." Not stolen. Not breached. Just sitting in plain text, one right-click away.
This is the check I keep coming back to when I look at an AI-built app, because it's fast, it's zero-code, and it's the one where "I didn't touch anything" isn't actually the reassurance it sounds like.
What this article covers
1. [What is it?](#s1)
2. [Why should you care if you don't code?](#s2)
3. [What does good look like?](#s3)
4. [What can you safely ask your AI agent?](#s4)
01 — What is it?
An API key is a password, except it's not for you — it's for one piece of software talking to another. When your app needs to charge a card through Stripe, or call OpenAI to generate some text, it has to prove it's allowed to make that request. The API key is that proof: a long string your app sends along with every request, the same way you'd type a password to prove it's really you logging in. It's a handshake between two systems, not between a person and a system.
That framing — machine password — covers most of it, but the details of *what kind* of key matter. A **house key** is the simplest case: whoever holds it gets in, full stop. Some API keys work exactly like that. Others behave more like a **library card**: it gets you into the building and lets you borrow books, but not into the manager's office or the cash register — the access is scoped to specific things. Good key design uses library-card keys wherever possible. An AI-generated integration may use a broader credential than the task actually requires, and a founder reviewing the result rarely has a way to tell which one it is.
Here's the part that actually differentiates this from "don't commit your `.env` file" advice you may have already heard. A particularly easy leak to create in an AI-built frontend is a key built directly into the code your users' browsers run, not into a file that got pushed to GitHub by accident. Frameworks like Next.js and Vite have a specific naming convention for this: any environment variable prefixed `NEXT_PUBLIC_` or `VITE_` gets bundled into the public JavaScript your site ships, by design — that's [documented, intended behavior](https://nextjs.org/docs/app/building-your-application/configuring/environment-variables), not a bug. It exists because some values genuinely need to reach the browser. The problem is an AI agent reaching for that prefix out of habit, for a value that was never meant to leave your server, because it's the fastest way to make an error go away.
02 — Why should you care if you don't code?
Because the consequence isn't abstract — it's a bill, or it's your users' data. If your OpenAI key is sitting in your public JavaScript, anyone who opens dev tools can copy it and start making calls on your account, and you find out when the invoice arrives, not before. If it's a Stripe key with the wrong scope, someone can potentially read payment data that belongs to your users, not you. This isn't an edge case reserved for large companies. It's also one of the easiest findings to make concrete, because an exposed value can sometimes be shown directly in the browser.
There's a precision worth getting exactly right, because the intuitive version of it is wrong: **an API key doesn't behave like an interactive password.** You'd notice if someone logged into your email — there's a session, a device, maybe a "new sign-in" email. API-key use usually doesn't produce the same user-facing sign-in signals as an interactive login. Unlike an interactive password, an API key may stay usable until it expires *or* someone revokes or rotates it — so a leaked key can keep working quietly, for weeks, without anything that looks like "someone logging in." Nobody has to breach anything. The key was already sitting there, working exactly as designed, for whoever found it.
This pattern is easy to create when an agent is optimizing for a demo that works. That makes it worth checking explicitly rather than assuming a working integration kept every credential in the right place.
03 — What does good look like?
You don't need to read code to get most of the way here. Look for:
- **Secrets live server-side only** — API keys for Stripe, OpenAI, or any paid service should never be readable from a file your browser downloads.
- **Sensitive credentials stay on your server, not on the user's device.** If your app needs to talk to a paid or private API (payments, LLMs, email, storage), the credential should live on your server. Your app calls your server; your server calls the paid API on the app's behalf and passes back only the result. This applies to browser code, mobile-app bundles, and desktop-app code alike — anything running on someone else's machine is extractable, regardless of framework or file naming. `NEXT_PUBLIC_` / `VITE_` prefixes are one common way this rule gets accidentally broken, but they're not the only one.
- **Keys are scoped, not universal** — a library-card key where a library-card key is available, rather than a house key handed out by default.
- **There's a plan for revoking or rotating a key**, not just for issuing one — since a key can keep working long after it should have stopped.
And here's the zero-code first check, the one you can run yourself in under a minute: open your live site, right-click anywhere, choose "View Page Source" (or press F12 to open developer tools and look at the page's source), and search — Ctrl+F or Cmd+F — for `key`, `sk-`, and `token`. If any of those turn up a long string that looks like a real credential sitting in plain text, that's worth investigating immediately.
I want to be precise about what that check actually tells you, because it's easy to over-read: **this is a first check, not proof that nothing is exposed.** A clean result means the easy, obvious version of this problem isn't visible on the one page you searched — not that no secret anywhere in your app is exposed. Keys can be built into JavaScript files loaded from other pages, other bundles, or behind a login you didn't check from. Treat a clean F12 search as "nothing jumped out," not as a certificate.
References: Fencer's "How to Secure Your Vibe Coded App" (fencer.dev) walks through this exact self-test for AI-built apps. On the framework side, see the official Next.js environment variables docs and the Vite env & mode guide for how each framework decides what gets bundled into public code. For the broader discipline, OWASP's Secrets Management Cheat Sheet and GitHub's push protection documentation are both worth a read if you want the fuller picture.
04 — What can you safely ask your AI agent?
You don't have to run the search yourself — you can ask your AI coding tool to do it, with wording that keeps the same "not found ≠ doesn't exist" honesty as the F12 check above. Paste this in as-is:
The prompt to paste into your AI tool
> Search this project for hard-coded secrets or API keys — including any bundled into the browser/frontend (e.g. `NEXT_PUBLIC_`/`VITE_` variables). Show me where each is and whether it ships to users. If your search finds nothing, say the search found nothing — don't conclude the app is clean. Don't change anything.
Read what it finds before acting on it. If it lists secrets that ship to the browser, that's your priority list — but this article stops at "here's what I found," not "here's how to fix it," on purpose. Moving a key server-side, reissuing it, and revoking the exposed one is real work worth getting right, and it's a conversation for whoever's technically responsible for this project, not a follow-up prompt you paste in on your own. [Anthropic's own guidance on API key best practices](https://support.anthropic.com/en/articles/9767949-api-key-best-practices-keeping-your-keys-safe-and-secure) is a good primer if the key in question is for an AI provider specifically.
This is one article in the Launch Readiness KB series, which walks through what a Trust Report scan actually looks for before you launch, hire, or raise on an AI-built app — one concept per article, always ending in something safe to ask your agent, never something that changes your code.
---
# https://mikbry.com/blog/kb/secrets-and-api-keys-fr/
# Ton IA vient d'écrire une clé API directement dans le code. Tes visiteurs peuvent-ils la voir ?
Mik Bry · 2026-08-25 · lecture ~8 min · KB · Prêt à lancer

Ton outil d'IA devait parler à Stripe, à OpenAI, ou à un autre service, donc il t'a demandé de coller une clé API — puis il l'a intégrée au code. Logique. Ce qui n'est pas évident, si tu ne codes pas, c'est que « intégrée au code » veut parfois dire « intégrée au code téléchargé par le navigateur de tes visiteurs ». Pas volée. Pas piratée. Juste posée en clair, à portée d'un clic droit.
C'est le test que je refais systématiquement sur une app construite par IA : rapide, sans code, et « je n'ai touché à rien » n'est justement pas la garantie qu'on croit.
Ce que couvre cet article
1. [C'est quoi, concrètement ?](#s1)
2. [Pourquoi s'en soucier si tu ne codes pas ?](#s2)
3. [À quoi ressemble un projet bien structuré ?](#s3)
4. [Que peux-tu demander sans risque à ton agent IA ?](#s4)
01 — C'est quoi, concrètement ?
Une clé API est un mot de passe, sauf qu'elle n'est pas pour toi — elle sert à un logiciel qui parle à un autre logiciel. Quand ton app doit débiter une carte via Stripe, ou appeler OpenAI pour générer du texte, elle doit prouver qu'elle a le droit de faire cette requête. La clé API, c'est cette preuve : une longue chaîne envoyée avec chaque requête, un peu comme toi quand tu tapes un mot de passe pour prouver que c'est bien toi. Une poignée de main entre deux systèmes, pas entre une personne et un système.
Cette image — mot de passe pour machines — couvre l'essentiel, mais le *type* de clé compte aussi. Une **clé de maison** est le cas le plus simple : qui la détient entre, un point c'est tout. Certaines clés API fonctionnent comme ça. D'autres se comportent plutôt comme une **carte de bibliothèque** : elle te fait entrer dans le bâtiment et emprunter des livres, mais ne t'ouvre ni le bureau du directeur ni la caisse — l'accès est limité. Une bonne gestion des clés privilégie les accès limités dès que c'est possible ; les outils d'IA ne choisissent pas toujours l'option la plus restreinte par défaut, et un fondateur qui relit le résultat n'a généralement aucun moyen de savoir laquelle des deux il a obtenue.
Voici ce qui différencie ce cas du conseil classique « ne commite pas ton fichier `.env` ». Un cas particulièrement facile à créer dans un frontend construit avec l'IA, c'est une clé écrite directement dans le code que le navigateur exécute — plutôt que dans un fichier poussé par erreur sur GitHub. Next.js et Vite ont une convention précise : toute variable préfixée `NEXT_PUBLIC_` ou `VITE_` est intégrée au JavaScript public du site — un [comportement documenté et volontaire](https://nextjs.org/docs/app/building-your-application/configuring/environment-variables), pas un bug, prévu pour les valeurs qui doivent réellement atteindre le navigateur. Le problème, c'est un agent IA qui utilise ce préfixe par réflexe, pour une valeur censée rester côté serveur, parce que c'est le moyen le plus rapide de faire disparaître une erreur.
02 — Pourquoi s'en soucier si tu ne codes pas ?
Parce que la conséquence n'a rien d'abstrait — c'est une facture, ou ce sont les données de tes utilisateurs. Si ta clé OpenAI est posée dans ton JavaScript public, n'importe qui peut ouvrir les outils de développement, la copier, et faire des appels sur ton compte — tu l'apprends en recevant la facture, pas avant. Si c'est une clé Stripe trop permissive, quelqu'un peut lire des données de paiement qui appartiennent à tes utilisateurs, pas à toi. Ce n'est pas un cas limite réservé aux grandes entreprises. C'est aussi l'un des problèmes les plus faciles à montrer concrètement, parce qu'une valeur exposée peut parfois être visible directement dans le navigateur.
Un point de précision à ne pas rater, parce que l'intuition trompe ici : **une clé API ne se comporte pas comme un mot de passe interactif.** Tu remarquerais si quelqu'un se connectait à ta messagerie — session, appareil, parfois un e-mail « nouvelle connexion ». L'utilisation d'une clé API ne produit généralement pas les mêmes signaux visibles qu'une connexion classique. Contrairement à un mot de passe interactif, elle peut rester utilisable jusqu'à son expiration *ou* jusqu'à ce que quelqu'un la révoque ou la fasse tourner — une clé qui a fuité peut donc continuer à fonctionner discrètement, pendant des semaines, sans rien qui ressemble à une « connexion ». Personne n'a besoin de pirater quoi que ce soit. La clé était déjà là, elle fonctionnait exactement comme prévu, pour quiconque la trouve.
Ce schéma est facile à créer quand un agent optimise pour une démo qui marche. D'où l'intérêt de vérifier explicitement, plutôt que de supposer qu'une intégration qui fonctionne a forcément gardé chaque identifiant au bon endroit.
03 — À quoi ressemble un projet bien structuré ?
Pas besoin de savoir lire du code pour vérifier l'essentiel. Cherche :
- **Les identifiants sensibles restent sur ton serveur, jamais dans le code envoyé à l'utilisateur.** Si ton app doit appeler une API payante ou privée (paiements, LLMs, email, stockage), la clé doit vivre sur ton serveur. Ton app appelle ton serveur ; ton serveur appelle l'API payante et te renvoie uniquement le résultat. Ça vaut pour le code du navigateur, les bundles d'apps mobiles et les apps desktop — tout ce qui tourne sur la machine de quelqu'un d'autre peut être extrait, quel que soit le framework ou le nom des fichiers. Les préfixes `NEXT_PUBLIC_` / `VITE_` sont un exemple courant, pas la seule façon dont cette règle peut être cassée.
- **Chaque clé n'ouvre que ce qu'elle doit ouvrir** — une carte de bibliothèque plutôt qu'une clé passe-partout.
- **Il existe un plan pour révoquer ou faire tourner une clé**, pas seulement pour en émettre une — une clé peut continuer à fonctionner bien après qu'elle aurait dû s'arrêter.
Et voici le premier test sans code, celui que tu peux faire toi-même en moins d'une minute : ouvre ton site en ligne, fais un clic droit, choisis « Afficher le code source de la page » (ou F12 pour ouvrir les outils de développement), et cherche — Ctrl+F ou Cmd+F — `key`, `sk-`, et `token`. Si l'une de ces recherches fait remonter une longue chaîne qui ressemble à un vrai identifiant en clair, ça mérite d'être vérifié immédiatement.
Je veux être précis sur ce que ce test révèle vraiment, parce qu'il est facile de le surinterpréter : **c'est un premier test, pas la preuve que rien n'est exposé.** Un résultat propre veut dire que la version évidente du problème n'apparaît pas sur la page cherchée — pas qu'aucun secret nulle part dans ton app n'est exposé. Des clés peuvent être intégrées dans des fichiers JavaScript chargés depuis d'autres pages, d'autres bundles, ou derrière une connexion non vérifiée. Prends une recherche F12 propre comme « rien n'a sauté aux yeux », pas comme un certificat.
04 — Que peux-tu demander sans risque à ton agent IA ?
Tu n'as pas besoin de faire cette recherche toi-même — demande à ton outil d'IA, avec une formulation qui garde la même honnêteté « pas trouvé ≠ n'existe pas » que le test F12. Copie-colle ce prompt tel quel :
Le prompt à coller dans ton outil d'IA
> Cherche dans ce projet des secrets ou clés API codés en dur — y compris ceux intégrés au navigateur/frontend (par exemple des variables `NEXT_PUBLIC_`/`VITE_`). Montre-moi où se trouve chacun et s'il est envoyé aux utilisateurs. Si ta recherche ne trouve rien, dis que la recherche n'a rien trouvé — ne conclus pas que l'app est propre. Ne change rien.
Lis ce qu'il trouve avant d'agir. S'il liste des secrets envoyés au navigateur, c'est ta liste de priorités — mais cet article s'arrête volontairement à « voici ce que j'ai trouvé », pas à « voici comment le corriger ». Déplacer une clé côté serveur, en émettre une nouvelle et révoquer celle qui a été exposée, c'est un vrai travail technique — à confier à la personne techniquement responsable du projet, pas un prompt de suivi que tu colles seul. Le [guide d'Anthropic sur les clés API](https://support.anthropic.com/fr/articles/9767949-api-key-best-practices-keeping-your-keys-safe-and-secure) est une bonne base si la clé sert un fournisseur d'IA.
Cet article fait partie de la série Launch Readiness KB : un concept à la fois pour comprendre ce que le Trust Report vérifie avant de lancer ton app, d'embaucher ou de lever des fonds. Chaque article se termine par quelque chose que tu peux demander à ton agent sans modifier le code.
---
# https://mikbry.com/blog/kb/what-ci-is/
# Your AI agent just said "it's done." What actually checked that?
Your AI coding tool says "done." It fixed the bug, added the field, pushed the change — done. That word is doing a lot of work in that sentence, and none of it is something you can verify just by reading it.
"Done" usually means the agent believes the change matches what you asked for. It doesn't usually mean that something else — separate from the agent's own account of its work — reran the project's checks and confirmed nothing broke.
Along with version history, this is one of the first things I look for when I review an AI-built app: is there a mechanism that reruns the known checks on the changes that matter, automatically, whether or not the agent thinks to mention it. Not because your agent is lying to you. Because "it's done" is a claim made in conversation, and a claim is not the same thing as a rerun.
What this article covers
1. [What is it?](#s1)
2. [Why should you care if you don't code?](#s2)
3. [What does good look like?](#s3)
4. [What can you safely ask your AI agent?](#s4)
01 — What is it?
CI stands for Continuous Integration. The name is unhelpful, so set it aside and hold onto the mechanism instead: CI is a separate, repeatable process that automatically runs configured checks when relevant code changes are pushed or proposed. Those checks may include building, type-checking, linting and tests. It repeats whatever checks you've configured — usually on a server somewhere, not on your agent's own machine. Martin Fowler, who has been writing about this since the 1990s, puts the core of it plainly: an automated build, "including test," that verifies every change to "detect integration errors as quickly as possible."
Here's the correction I want to make before this goes any further, because it's the one existing explainers tend to skip: CI is not an independent reviewer looking over your agent's shoulder. The same agent that wrote the code may well have written the tests CI runs, and the configuration that tells CI what to check. CI doesn't add a second opinion. What it adds is narrower, and still genuinely valuable — **repeatability**. The same known checks, run the same way, on the changes that matter, whether or not a human or an agent remembers to run them by hand.
Think of a pilot with ten thousand hours in the air, still running the pre-flight checklist before every single flight. Not because that pilot distrusts their own judgment — because a checklist that only sometimes gets read isn't a checklist, it's a suggestion. CI is the part of the process that never skips the checklist, because it can't get busy, forget, or decide "this change is small, it'll be fine."
And CI's job stops there, deliberately. Fowler makes this point too: whether to actually release what CI verified is, in his words, "a business decision" — a separate step, made by people, informed by what CI found. CI doesn't decide to ship. It just makes sure that whoever does decide is deciding with the checks actually rerun, not just a conversational "it's done."
02 — Why should you care if you don't code?
Because your agent can say "done," mean it sincerely, and still be wrong — and without CI, the first time anyone reruns the actual checks might be the moment a customer's card gets declined, not the moment before you shipped.
[Build vs tests](/blog/kb/build-vs-tests/), another article in this series, covers the gap between a build that compiles and a product that actually works: a green build proves the checks that build included passed, nothing more. CI is the piece that closes that gap in practice — it's the thing that actually reruns those tests, automatically, on the changes that matter, instead of once when someone happened to write them and never again.
Without CI, checking becomes a rare, dreaded event: something that only happens right before a big release, under time pressure, when everyone's least equipped to deal with what it finds. With it, checking becomes a non-event — something that happens quietly, the same way, dozens of times a week, so small enough that nobody has to brace for it. That shift, from occasional and stressful to routine and boring, is most of what CI is actually buying you.
03 — What does good look like?
You don't need to read a line of configuration to check this. Look for:
- **It runs automatically on the changes that matter** — for example when code is pushed or a pull request is opened.
- **It reruns checks that already exist** — the build, the tests already written for this project. CI doesn't invent new judgment; it's only as good as what it's been told to check.
- **The result is visible without reading code** — a green checkmark or a red cross next to each change, the kind of status [GitHub Actions](https://github.blog/developer-skills/github/github-for-beginners-getting-started-with-github-actions/) shows on every pull request.
- **It runs somewhere other than one person's laptop** — so "it works on my machine" isn't the final word on whether it works.
- **A failure is something people actually see**, not a red status nobody's watching.
If your project has none of this, that's not automatically a crisis — a very early prototype might not need it yet. But once real users are involved, this is the difference between finding a broken change in a few minutes and finding it from a support email.
Reference: Red Hat's overview of CI/CD is a good next read if you want the fuller picture beyond what one article can cover.
04 — What can you safely ask your AI agent?
You don't need to find any of this yourself. Ask your AI coding tool to show you — and the exact wording matters, because "I didn't find anything" is not the same claim as "there is nothing." If your agent can't find a CI setup, the honest answer is that it couldn't find one, not that none exists. Paste this in as-is:
The prompt to paste into your AI tool
> List every check that runs automatically before this app is deployed — builds, tests, anything — and where each is configured. If you can't find any, say you couldn't find one — don't assume none exists. Don't add or change anything.
Read the answer before acting on it. If your agent lists a real, automated pipeline that reruns builds and tests on the changes that matter, that's what good looks like from section 3, confirmed. If it comes back empty, that's not proof nothing exists — but it's a real starting point, and one worth understanding before the next change ships on top of it.
This is one article in the Launch Readiness KB series that walks through what a Trust Report scan actually looks for before you launch, hire, or raise on an AI-built app — one concept per article, always ending in something safe to ask your agent, never something that changes your code.
---
# https://mikbry.com/blog/kb/what-ci-is-fr/
# Ton IA vient de dire « c'est fait ». Qu'est-ce qui a vraiment vérifié ça ?
Mik Bry · 2026-08-25 · lecture ~7 min · KB · Prêt à lancer

Ton outil d'IA dit « c'est fait ». Il a corrigé le bug, ajouté le champ, poussé le changement — fait. Mais « c'est fait » ne dit pas ce qui a réellement été vérifié.
« C'est fait » veut généralement dire que l'agent pense que le changement correspond à ce que tu as demandé. Ça ne veut pas dire qu'un mécanisme séparé a relancé les vérifications du projet.
Avec l'historique de versions, c'est l'une des premières choses que je regarde quand j'examine une app construite avec l'IA : est-ce qu'il existe un mécanisme qui relance les vérifications connues sur les changements concernés, automatiquement, que l'agent pense à le mentionner ou non. Pas parce que ton agent te ment. Parce que « c'est fait » est une affirmation faite dans une conversation, et une affirmation n'est pas la même chose qu'une vérification relancée.
Ce que couvre cet article
1. [C'est quoi, concrètement ?](#s1)
2. [Pourquoi s'en soucier si tu ne codes pas ?](#s2)
3. [À quoi ressemble un projet bien structuré ?](#s3)
4. [Que peux-tu demander sans risque à ton agent IA ?](#s4)
01 — C'est quoi, concrètement ?
CI veut dire Continuous Integration — intégration continue. Le nom n'aide pas beaucoup, alors laisse-le de côté et retiens plutôt le mécanisme : la CI est un processus séparé et répétable qui exécute automatiquement des vérifications configurées quand du code pertinent est poussé ou proposé en pull request. Ces vérifications peuvent inclure la construction (le build), le typage, le linting et les tests. Elle répète tout ce que tu as configuré — en général sur un serveur, pas sur la machine de ton agent. Martin Fowler, qui écrit là-dessus depuis les années 1990, résume l'essentiel simplement : une construction automatisée, « tests compris », qui vérifie chaque changement pour « détecter les erreurs d'intégration le plus vite possible ».
Voici la précision que je veux poser avant d'aller plus loin, parce que beaucoup d'explications passent ce point sous silence : la CI n'est pas un relecteur indépendant qui surveille ton agent par-dessus son épaule. Le même agent qui a écrit le code a très bien pu écrire les tests que la CI fait tourner, et la configuration qui lui dit quoi vérifier. La CI n'ajoute pas un second avis. Ce qu'elle apporte est plus limité, mais très utile : la **répétabilité**. Les mêmes vérifications connues, relancées de la même façon, sur les changements concernés, que quelqu'un — humain ou agent — pense à les relancer à la main ou non.
Pense à un pilote qui a dix mille heures de vol et qui refait quand même la checklist avant chaque décollage. Pas parce qu'il doute de son propre jugement — parce qu'une checklist qu'on ne lit que de temps en temps n'est plus une checklist, c'est une suggestion. La CI, c'est la partie du processus qui ne saute jamais la checklist, parce qu'elle ne peut ni être débordée, ni oublier, ni décider « ce changement est petit, ça ira ».
Et le rôle de la CI s'arrête là, volontairement. Fowler insiste aussi sur ce point : décider de vraiment publier ce que la CI a vérifié reste, selon ses mots, « une décision business » — une étape séparée, prise par des humains, informée par ce que la CI a trouvé. La CI ne décide pas de mettre en ligne. Elle s'assure juste que celui qui décide le fait avec les vérifications vraiment relancées, pas juste un « c'est fait » dit en passant.
02 — Pourquoi s'en soucier si tu ne codes pas ?
Parce que ton agent peut dire « c'est fait », le penser sincèrement, et se tromper quand même — et sans CI, la première fois que quelqu'un relance vraiment les vérifications, ce sera peut-être au moment où la carte d'un client se fait refuser, pas avant que tu ne mettes en ligne.
[Build vs tests](/blog/kb/build-vs-tests-fr/), un autre article de cette série, parle de l'écart entre un build qui compile et un produit qui marche vraiment : un build vert prouve seulement que les vérifications incluses dans ce build sont passées, rien de plus. C'est là que la CI devient utile : elle relance automatiquement ces vérifications, sur les changements concernés, au lieu de dépendre de quelqu'un qui pense à les lancer manuellement.
Sans CI, vérifier devient un événement rare et redouté : quelque chose qui arrive seulement juste avant une grosse mise en production, sous pression, au moment où tout le monde est le moins équipé pour gérer ce que ça révèle. Avec elle, la vérification devient une routine banale : elle tourne discrètement, toujours de la même façon. Ce basculement, d'occasionnel et stressant à routinier et banal, c'est à peu près ce que la CI t'apporte réellement.
03 — À quoi ressemble un projet bien structuré ?
Pas besoin de lire une ligne de configuration pour vérifier l'essentiel. Cherche :
- **Ça tourne automatiquement sur les changements concernés** — par exemple quand du code est poussé ou qu'une pull request est ouverte.
- **Ça relance des vérifications qui existent déjà** — le build, les tests déjà écrits pour ce projet. La CI n'invente pas de nouveau jugement ; elle vaut ce qu'on lui a dit de vérifier.
- **Le résultat est visible sans lire de code** — une coche verte ou une croix rouge à côté de chaque changement, le genre de statut que [GitHub Actions](https://github.blog/developer-skills/github/github-for-beginners-getting-started-with-github-actions/) affiche sur chaque pull request.
- **Ça tourne ailleurs que sur l'ordinateur d'une seule personne** — pour que « ça marche chez moi » ne soit pas le dernier mot sur si ça marche vraiment.
- **Quand une vérification échoue, quelqu'un est réellement prévenu** — pas un statut rouge que personne ne regarde.
Si ton projet n'a rien de tout ça, ce n'est pas automatiquement une crise — un tout jeune prototype n'en a peut-être pas encore besoin. Mais dès que de vrais utilisateurs entrent en jeu, c'est la différence entre trouver un changement cassé en quelques minutes, ou le découvrir par un email de support.
Référence : l'aperçu de la CI/CD par Red Hat est une bonne suite de lecture si tu veux la vue d'ensemble au-delà de ce qu'un seul article peut couvrir.
04 — Que peux-tu demander sans risque à ton agent IA ?
Tu n'as besoin de trouver aucun de ces points toi-même. Demande à ton outil d'IA de te montrer — et la formulation exacte compte, parce que « je n'ai rien trouvé » n'affirme pas la même chose que « il n'y a rien ». Si ton agent ne trouve pas de CI, la réponse honnête est qu'il n'en a pas trouvé, pas qu'il n'en existe pas. Copie-colle ce prompt tel quel :
Le prompt à coller dans ton outil d'IA
> Liste toutes les vérifications qui tournent automatiquement avant que cette app soit déployée — builds, tests, tout ce qui existe — et où chacune est configurée. Si tu n'en trouves aucune, dis-moi que tu n'en as pas trouvé — ne suppose pas qu'il n'y en a pas. Ne rajoute et ne change rien.
Lis la réponse avant d'agir dessus. Si ton agent liste un vrai pipeline automatisé qui relance builds et tests sur les changements concernés, c'est exactement ce que décrit la section 3 pour un projet bien structuré, confirmé. S'il revient bredouille, ça ne prouve pas que rien n'existe — mais c'est un vrai point de départ, et ça vaut la peine de le comprendre avant que le prochain changement soit mis en production.
Cet article fait partie de la série Launch Readiness KB : un concept à la fois pour comprendre ce que le Trust Report vérifie avant de lancer ton app, d'embaucher ou de lever des fonds. Chaque article se termine par quelque chose que tu peux demander à ton agent sans modifier le code.
---
# https://mikbry.com/blog/javascript/npm/best-practices-npm-package/
# How to master the art of npm packaging
You want to publish your brand new javascript library using npmjs ? In this article I will give you some valuable tips on how to build the perfect, slick and efficient package.
Firstly, why do you want to publish to npmjs ? You should read this : [become a better developer](https://dev.to/thegeoffstevens/why-publishing-your-own-npm-packages-can-make-you-a-better-developer-2lc6).
Ok are you ready ?
## Publish
`$ npm publish`
There are many articles explaining how to start publishing your npm package. So I will not detail it here.
You should read npmjs documentation at first :
[Npm Publish](https://docs.npmjs.com/cli/publish)
Once your are confident with publishing process, some points need to be validated :
- [Make sure your package installs and works](https://docs.npmjs.com/misc/developers#before-publishing-make-sure-your-package-installs-and-works)
- Did you check the files included in your package ?
- Are you sure that all the entries in the package.json are useful ?
- Did your package works smoothly on all targets ?
To check these points and others I recommend you to use [np](https://github.com/sindresorhus/np) a tool that will help you follow some good practices.
But it is not enough. As recent version of Node.js and browsers are compatibles with ESM (Import) and ES6+ syntax, you need a publishing strategy to target your audience.
## Modern javascript : targeting ESM but stay compatible with CommonJS
This strategy will help you develop and publish using modern javascript with no boilerplate and maintain a retro compatibility with older javascript engines.
You should read this article to understand how it works : [Hybrid npm packages](https://2ality.com/2019/10/hybrid-npm-packages.html).
I mainly use [Rollup bundler](https://rollupjs.org/) to build a legacy package with support for ESM and CommonJS. Rollup will create two code bases:
- index.mjs : same as you code source
- index.js : your code source is transformed to CommonJS. You could also use Babel to transpile your code to older targets.
Your package.json contains two entries:
```json
{
"main": "index.js",
"module": "index.mjs",
}
```
## A minimal file structure
A package should contain at least :
```
- index.js
- package.json
- README
- LICENSE
```
package.json is the only mandatory file, as it describes your package. But without index.js it is useless. You should also add some information with a README (README.md) file and a LICENSE file.
I recommend this structure for modern javascript bundles as we seen previously:
```
- index.js
- index.js.map
- index.mjs
- index.mjs.map
- package.json
- README.md
- CHANGELOG.md
- LICENSE
```
`*.map` files are useful for debugging purposes.
## Package.json: some unnecessary items
package.json is used mainly in 2 stages:
- during development: some fields like scripts, devDependencies or configurations for dev tools (Husky, ESLint, ...)
- As a descriptor for publishing: dependencies is the most important object. It lists all necessary modules to install.
But items used for development like scripts, devDependencies stay present in the published bundle.
Note: some scripts could be executed during installation/uninstallation steps. It could give you some extra control on how your library is used.. Like calling a webservice to count how many packages are really installed. See : [Npm scripts](https://docs.npmjs.com/misc/scripts)
## Package your library
You don't need to publish all stuff from your project. Some files or directories should be excluded. You have 3 methods to do so.
[Keeping files out of your package](https://docs.npmjs.com/misc/developers#keeping-files-out-of-your-package)
### 1 - Using .npmignore or .gitignore
You exclude files using patterns from the bundle.
### 2 - Using files field in package.json
It works the opposite of #1, files contains an array of file patterns.
Note : in CommonJS package spec, you should detail how the struct of your package is using a 'directories' object. But I don't use it anymore.
[Npm package.json files](https://docs.npmjs.com/files/package.json#files)
### 3 - Using a dist folder
You need to copy all necessary files to a dist folder, and then add this folder to npm publish command:
```
$ npm build ./dist
$ cp ./README.md ./dist/README.md
$ cp ./package.json./dist/package.json
$ ...
$ npm publish ./dist
```
By doing so you have a better control on what to publish. dist folder is only dedicated to publishing (and building) so you could make some changes, reordering on included files. For example, you could change package.json without corrupting project's one, see next.
## Use Packito to clean your package before publishing it
I created this tool to go further in packaging npm module. It is a superset of previous step 3. In a dist folder, it will copy mandatory and selected files, but also refactor package.json to remove/change some fields.
[Packito repository](https://github.com/mikbry/packito)
So Packito will help you:
- clean your package.json
- no more scripting to copy files in dist
Here is a sample .packito.json.
```json
{
"remove": {
"devDependencies": "*",
"scripts": "*",
"type": true,
"esm": true,
"husky": true,
"commitlint": true
},
"replace": {
"main": "index.js",
"module": "index.mjs"
},
"publisher": {
"name": "yarn test"
},
"output": "./dist",
"copy": ["bin", "README.md", "LICENSE"]
}
```
Here, I use esm module for dev, test and coverage. I also setup husky and commitlint. So all references to these tools in dist/packages.json are useless for publishing so they will be removed. Also I use different paths for main and module fields, as index.* files are not present at the root during development stage, instead of publishing stage.
Package.json extracted from packito :
```json
{
"name": "packito",
"version": "0.4.0",
"description": "clean your package before publishing it !",
"main": "dist/index.js",
"module": "dist/index.mjs",
"repository": "https://github.com/mikbry/packito.git",
"bugs": "https://github.com/mikbry/packito/issues",
"homepage": "https://github.com/mikbry/packito",
"author": "Mik ",
"license": "MIT",
"scripts": {
"build": "rollup -c && ./bin/packito.js",
"dev": "rollup -c && cross-env NODE_ENV=development node ./dist",
"lint": "$(yarn bin)/eslint src",
"test": "cross-env NODE_ENV=test $(yarn bin)/mocha --require esm",
"coverage": "cross-env NODE_ENV=test $(yarn bin)/nyc _mocha",
"report-coverage": "$(yarn bin)/nyc report --reporter=text-lcov > coverage.lcov",
"prepublishOnly": "yarn build"
},
"bin": {
"packito": "./bin/packito.js"
},
"engines": {
"node": ">=10"
},
"dependencies": {
"chalk": "^3.0.0",
"minimist": "^1.2.0",
"node-emoji": "^1.10.0"
},
"devDependencies": {
"@commitlint/cli": "^8.2.0",
"@commitlint/config-conventional": "^8.2.0",
"@rollup/plugin-json": "^4.0.0",
"@rollup/plugin-node-resolve": "^6.0.0",
"chai": "^4.2.0",
"cross-env": "^6.0.3",
"eslint": "^6.7.2",
"eslint-config-airbnb-base": "^14.0.0",
"eslint-config-prettier": "^6.7.0",
"eslint-plugin-import": "^2.19.1",
"eslint-plugin-jest": "^23.1.1",
"eslint-plugin-prettier": "^3.1.1",
"esm": "^3.2.25",
"husky": "^3.1.0",
"mocha": "^6.2.2",
"nodemon": "^2.0.1",
"nyc": "^14.1.1",
"prettier": "^1.19.1",
"rimraf": "^3.0.0",
"rollup": "^1.27.9"
},
"husky": {
"hooks": {
"pre-commit": "yarn lint",
"commit-msg": "[[ -n $HUSKY_BYPASS ]] || commitlint -E HUSKY_GIT_PARAMS"
},
"commitlint": {
"extends": [
"@commitlint/config-conventional"
]
}
}
}
```
You have a 65 lines json...
Generated package.json in ./dist
```json
{
"name": "packito",
"version": "0.4.0",
"description": "clean your package before publishing it !",
"main": "index.js",
"module": "index.mjs",
"repository": "https://github.com/mikbry/packito.git",
"bugs": "https://github.com/mikbry/packito/issues",
"homepage": "https://github.com/mikbry/packito",
"author": "Mik ",
"license": "MIT",
"bin": {
"packito": "./bin/packito.js"
},
"engines": {
"node": ">=10"
},
"dependencies": {
"chalk": "^3.0.0",
"minimist": "^1.2.0",
"node-emoji": "^1.10.0"
}
}
```
Now you get 23 lines !
And package structure is optimized to :
```
- index.js
- index.js.map
- index.mjs
- index.mjs.map
- package.json
- README.md
- LICENSE
```
Distributing a polished and slick package is a respectful act. It is like ‘the cherry on the cake’. All pieces are well developed, tested, packaged and at the right place. Nothing is superfluous. And your code is much more clear for other team members working on it. You are a master-chief !
Don't hesitate to help me enhance [Packito](https://github.com/mikbry/packito), star it and give me some feedback.
Star
**Thanks for reading !**
---
# https://mikbry.com/blog/nextjs/tailwind/typescript/starter/migrate-jekyll-to-modern-stack-starter-part1/
# Modernizing Legacy Websites: Migrating from Jekyll to Nextjs (Part 1 - Setup)
This guide explains how to migrate Jekyll to Next.js while preserving content and introducing React, TypeScript, Tailwind, and shadcn/ui.
In the fast-paced world of web development, keeping your website up-to-date is crucial for maintaining performance, security, and user engagement. Many developers and organizations find themselves with legacy websites built on older static site generators like Jekyll. While Jekyll has served us well, modern frameworks like Next.js offer significant advantages in terms of performance, developer experience, and scalability.
This comprehensive guide is the first in a series that will walk you through the process of migrating a legacy website to a modern Next.js application using Typescript language, React and Tailwind packages. We'll cover everything from initial template setup to deployment, ensuring your transition is smooth and your new site leverages the full power of modern web technologies.
## Understanding the Need for Legacy Website Migration
Before we dive into the technical details, let's explore why migrating from our legacy Jekyll to Nextjs is a worthwhile endeavor:
1. **Performance Improvements**: Next.js and React offers server-side rendering and automatic code splitting, significantly enhancing your site's loading speed and overall performance.
2. **Enhanced Developer Experience**: With hot module replacement and a more intuitive project structure, Next.js streamlines the development process. Also an easy deployment using Vercel or Github Actions is a must have.
3. **Scalability**: As your site grows, Nextjs provides built-in features like API routes and dynamic imports to handle increased complexity.
4. **Modern JavaScript Features**: Next.js allows you to leverage the latest ECMAScript features and TypeScript for improved code quality and maintainability.
5. **Rich Ecosystem**: The React and Next.js ecosystems offer a wealth of libraries and tools to extend your site's functionality.
6. **Modern UI**: Using Tailwind and Shadcn Ui we get a professional and beautiful website.
6. **SEO Benefits**: Server-side rendering and automatic static optimization in Next.js can improve your site's search engine rankings.
## Assessing Your Legacy Jekyll Site
Before beginning the migration process, it's essential to thoroughly assess your current site. This evaluation will help you plan your migration strategy and identify potential challenges.
1. **Content Structure**: Analyze how your content is organized in our Jekyll Github repository. Are you using collections, categories, or tags? How are your posts and pages structured?
2. **Custom Plugins**: Identify any custom Jekyll plugins you're using. You'll need to find Nextjs equivalents or create custom solutions.
3. **Theme and Styling**: Evaluate your current theme and CSS framework. Are you using a pre-built theme or custom styles? As we are using Tailwind CSS and Shadcn UI the best is to restart from zero the layout. Using a starter or template available online or on Github it is an easy step.
4. **Build Process**: Review your build process, including any pre- or post-processing steps like Github Actions.
5. **Deployment**: Understand your current deployment strategy. Are you using GitHub Pages or another hosting solution?
6. **Dynamic Features**: Identify any dynamic features implemented in your site, such as search functionality or contact forms. And find corresponding React and or Shadcn component.
Before diving into our starter example, attempt to run the existing site:
If necessary, we should update denpendencies.
These attempts revealed outdated dependencies and compatibility issues, solidifying the decision to migrate.
## Setting Up Your Nextjs with Tailwind & React Project using Shadcn
Now that we've assessed our legacy site, let's set up our Next.js project. We'll use create-next-app to bootstrap our project with some modern tooling.
1. Requirements:
- Node.js 20 or later
- npm (or your preferred package manager)
- A github account to access example code.
Create a new Nextjs app using Shadcn starter tool:
1. Init with Shadcn using:
this command will install Next.js with typescript language, react and tailwind packages. You just have to follow the template recommandations.
2. Navigate to your new starter directory:
3. Install Lucide for icons:
this packages are beautiful icons for your react project.
4. Add Shadcn/ui components:
A simple starter to show how to install Shadcn ui components. Shadcn ui is based on Tailwind CSS and RadixUI.
## Template Structure for Migrated Content
Next, let's set up a template structure in our Next.js project to accommodate our migrated Jekyll content:
```text {0}
my-app/
├── app/
├── components/
├── content/
│ ├── pages/
│ ├── posts/
│ ├── drafts/
│ └── config.json
├── lib/
├── public/
└── [Next.js config files]
```
This structure separates our content from our Typescript application code, making it easier to manage and update.
## Migrating Content from Jekyll to our starter Nextjs project
Now, let's start migrating our content to our new Next.js starter project:
1. Copy all your Jekyll posts from `_posts/` to `content/posts/` in your starter project.
2. Copy your Jekyll pages (like `about.md`, `contact.md`) to `content/pages/` in your starter project.
3. Move your images and other assets from Jekyll's `assets/` folder to `public/` in your starter project.
4. Convert `_config.yml` to `config.json`:
```json showLineNumbers github filename="./config.json"
{
"title": "@mikbry",
"author": "Mik Bry 🤖",
"email": "xxx",
"description": "Innovative CTO & Founder 🚀 • Rust & Web Full-Stack Expert 💻 • AI Video & 3D Enthusiast 🤖 • 25+ Y in Tech 🏆 Team Leadership 👥• Pushing Tech Boundaries ✨\"",
"url": "https://mikbry.com",
"social_links": {
"github": "mikbry",
"twitter": "mikbry",
"linkedin": "mikbry"
},
"nav_pages": [
"projects",
"blog",
"about"
]
}
```
## Add Typescript Definitions
Create a typescript file `./lib/types.ts`:
``` typescript showLineNumbers filename="./lib/types.ts"
import { Author } from "next/dist/lib/metadata/types/metadata-types";
export type Configuration = {
title: string;
locale: string;
author: Author;
email: string;
description: string;
base_url: string;
url: string;
social_links: {
github?: string;
twitter?: string;
linkedin?: string;
},
permalink?: string;
nav_pages: string[];
}
```
### Local Development and Testing
Start the development server:
Visit `http://localhost:3000` to see your new React site in action. Shadcn ui and tailwind css is used to template it.
## Conclusion and Next Steps
In this first part of our series on migrating legacy Jekyll websites to Nextjs, we've covered the initial setup and content migration strategies. We've created a solid foundation for our modernized website, including:
1. Setting up a Nextjs starter project using Shadcn with TypeScript and Tailwind CSS
2. Creating a template for migrated content
3. Implementing basic content parsing and rendering
4. Setting up essential components for our new site
In the next part of this series, we'll dive deeper into rendering our migrated content, implementing dynamic routing for blog posts, and styling our new Nextjs site to match (or improve upon) our original Jekyll design.
By following this migration process, you're not just updating your technology stack – you're investing in a more scalable, performant, and developer-friendly website. The move from Jekyll to Nextjs opens up a world of possibilities for extending and improving your site, ensuring it remains modern and efficient for years to come.
Stay tuned for the next installment in this starter website migration series!
## Bonus the code is available on Github repository!
You could access the starter here: [starter part 1](https://github.com/mikbry/next-blog/tree/main/examples/part1)
---
---
# https://mikbry.com/launch-readiness/
---
# https://mikbry.com/pret-a-lancer/